Опрос
|
реклама
Быстрый переход
Google представила ИИ-ускорители TPU 8tx и TPU 8i Max, заточенные под конфиденциальность и огромные контексты
09.11.2026 [18:09],
Сергей Сурабекянц
Google расширила свою линейку тензорных процессоров (TPU) восьмого поколения, представив TPU 8tx для безопасного и конфиденциального выполнения логических операций (инференса) и TPU 8i Max для работы с огромными контекстными окнами. По словам компании, эти системы оптимизированы для задач с использованием ИИ-агентов. Главными приоритетами при их создании стали безопасность, высокая плотность вычислений и улучшенные возможности логического вывода. 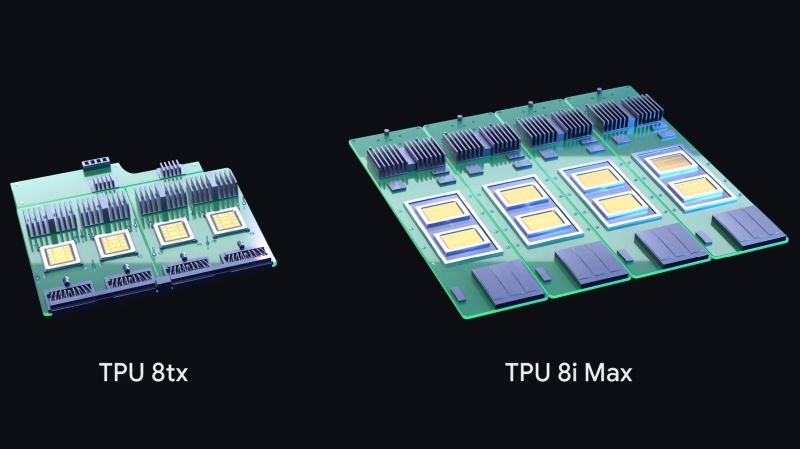
Источник изображений: Google Первые TPU (Tensor Processing Units) были разработаны Google более десяти лет назад для удовлетворения внутренних потребностей компании. Спустя восемь поколений сфера применения TPU значительно расширилась: теперь они используются для обучения и запуска ИИ-моделей Gemini, работы ИИ-агентов, предоставления услуг клиентам Google Cloud, а также для развёртывания TPU непосредственно в дата-центрах клиентов компании. В апреле, на конференции Google Cloud Next, компания представила два новых специализированных TPU: 8t — для масштабного обучения моделей, и 8i — для выполнения логических операций в режиме реального времени. По данным компании, по сравнению с предыдущим поколением TPU 8t обеспечивают до 2,7 раза более высокую производительность при обучении, а TPU 8i — на 80 % более выгодное соотношение цены и производительности при выполнении логических операций. Сегодня линейка TPU Google восьмого поколения пополнилась ещё двумя системами: TPU 8i Max, предназначенной для работы с огромными контекстными окнами и обеспечивающей максимальную вычислительную плотность на одну стойку, и TPU 8tx, созданной для безопасного и конфиденциального выполнения логических операций. Компания подчеркнула, что представляет не просто чипы, а системы на базе TPU. Разработка нового чипа — это многолетний процесс, включающий размещение миллиардов микроскопических транзисторов на кремниевой пластине; он ограничен законами физики и сложным, длительным производственным циклом. Система же — это способ объединения вычислительных мощностей, сетевых ресурсов и систем хранения данных вокруг чипа. Сюда входит, в частности, компоновка этих элементов вместе с чипами, что позволяет оперативно реагировать на возникающие потребности клиентов и новые сценарии использования в исследованиях. Поскольку программное обеспечение для ИИ развивается гораздо быстрее, чем технологии производства чипов, разработчики тензорных процессоров сделали ставку на системный баланс и модульность, спроектировав TPU как своего рода «строительные блоки» для системы AI Hypercomputer. Каждая система в линейке TPU восьмого поколения предназначена для решения конкретных задач на разных этапах жизненного цикла ИИ. 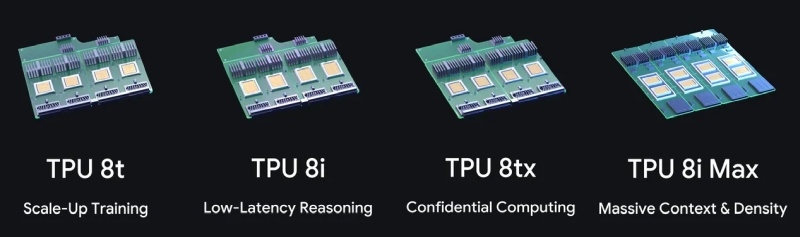 TPU 8t спроектирован как мощный инструмент для обучения масштабных базовых моделей (foundation models), обеспечивающий максимальный показатель «полезной производительности» (goodput) — то есть объём «полезного интеллекта», получаемый на каждый ватт затраченной энергии. TPU 8i — это вычислительный модуль для задач логического вывода (reasoning), разработанный для преодоления «барьера памяти» (memory wall) и сокращения задержек при обмене данными между чипами — вплоть до 50 %. TPU 8tx — система, предназначенная для безопасного и конфиденциального выполнения логических операций (инференса). Она разработана для государственных организаций и компаний, работающих в строго регулируемых отраслях, которым необходимо использовать передовые или проприетарные модели и автономных агентов, работая при этом с наиболее чувствительными данными. TPU 8tx обеспечивает безопасность на аппаратном уровне. Это позволяет сохранять конфиденциальные данные и веса моделей защищёнными и изолированными даже в процессе их активного использования. Благодаря внедрению сети Boardfly с низкой задержкой, TPU 8tx обеспечивает эффективную работу многошаговых агентов. Задержка при этом сокращается вдвое по сравнению с TPU 8t, практически без потери производительности. С помощью TPU 8tx команды могут дообучать (fine-tune) модели на собственных закрытых данных, выполнять дистилляцию крупных моделей в более компактные версии, а также обучать агентов методами обучения с подкреплением — и всё это без необходимости перемещать конфиденциальные данные между различными кластерами. 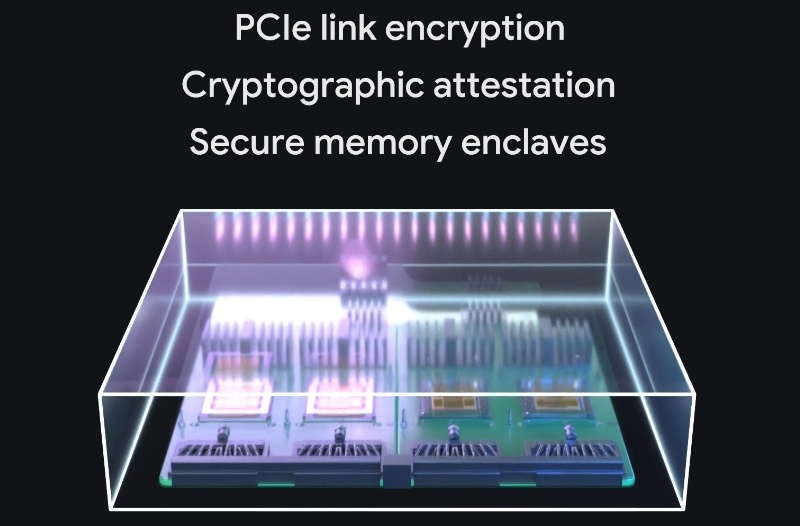 Система TPU 8i Max создана для преодоления так называемого «барьера памяти» (memory wall). Она объединила два чипа TPU 8i в единый модуль. В TPU 8i Max вычислительная мощность и объём памяти масштабируются синхронно: система предлагает вдвое больше вычислительных ресурсов, вдвое больше SRAM-памяти и вдвое более высокую пропускную способность HBM-памяти по сравнению с TPU 8i. Это гарантирует, что процессоры всегда обеспечены необходимыми данными, а выполнение масштабных задач не прерывается из-за нехватки ресурсов. Кроме того, поскольку TPU 8i Max вмещает вдвое больше кремниевых компонентов в рамках тех же габаритов, что и предыдущие решения, дата-центры могут значительно увеличить вычислительную мощность на единицу площади и на ватт потребляемой энергии. 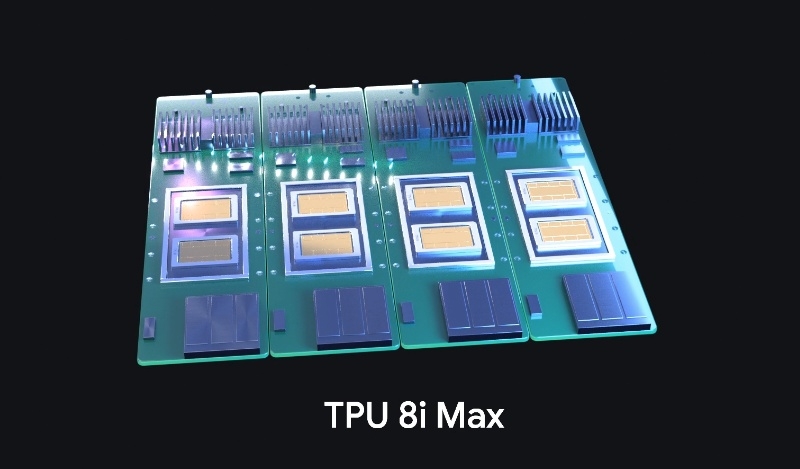 Таким образом, четыре системы TPU восьмого поколения обеспечивают гибкость для различных типов рабочих нагрузок и предоставляют клиентам специализированные ускорители для каждого этапа жизненного цикла интеллектуальных агентов (agentic lifecycle). TPU 8t предназначены для масштабируемого обучения моделей, TPU 8i — для выполнения логических операций (инференса) с низкой задержкой, TPU 8tx — для конфиденциальных вычислений, а TPU 8i Max — для работы с огромными контекстными окнами и обеспечения максимальной вычислительной плотности на одну стойку. Одновременно с разработкой новых TPU, Google стремится сделать их использование таким же простым, как и работу с универсальным оборудованием. В частности, разработчикам на PyTorch больше не придётся переписывать код — в прошлом месяце Google открыла исходный код TorchTPU. Теперь код на PyTorch и модели из библиотеки Hugging Face могут нативно выполняться на TPU. Кроме того, компания обеспечила поддержку TPU для популярных движков инференса с открытым исходным кодом, таких как vLLM и SGLang. Google выпустила набор инструментов TPU Agent, который пока доступен в режиме предварительного просмотра. Он интегрируется в такие среды разработки, как Claude Code, Cursor и Google Antigravity, позволяя быстро настроить работу с TPU, выявить узкие места и автоматически оптимизировать пользовательские ядра с помощью простых текстовых запросов. Для промышленного развёртывания компания предлагает новый движок XLA Serving Engine с открытым исходным кодом: он позволяет обучать модели на Python, а затем запускать их в высокопроизводительной среде C++ с низкой задержкой — на TPU, GPU или CPU. |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.


 MWC 2018
 2018
 Computex
 IFA 2018