


Опрос
|
реклама
Быстрый переход
«Прибыль важнее безопасности»: восемь штатов США подали в суд на OpenAI за вредный ChatGPT
15.10.2026 [11:54],
Павел Котов
Власти американских штатов Айова, Канзас, Небраска, Западная Вирджиния, Арканзас, Аризона, Айдахо и Монтана подали в суд на OpenAI, обвинив компанию в том, что она наносит вред детям и вводит пользователей в заблуждение относительно безопасности ChatGPT. Лаборатория искусственного интеллекта, по версии истцов, вразрез с законом поставила получение прибыли выше вопросов безопасности. 
Источник изображения: Brecht Corbeel / unsplash.com OpenAI нарушила законы штатов о защите прав потребителей, не предупредив пользователей об опасностях, связанных с ChatGPT. В качестве доводов приводятся иски, поданные родственниками подростков и совершеннолетних, в которых указывается, что чат-бот сыграл роль в смерти их близких. OpenAI, говорится в исках, позиционировала ChatGPT как «подходящий для молодёжи инструмент с приоритетом на безопасность», но в действительности он «опасен для уязвимых пользователей», потому что может «ослаблять навыки критического мышления, провоцировать паранойю и бредовые состояния, давать опасные медицинские советы и способствовать формированию нездоровых поведения и отношений». Компания обвиняется в сборе данных несовершеннолетних и в том, что она прилагает недостаточно сил, чтобы оградить малолетних пользователей от доступа к чат-боту. Указывается на «безрассудство» OpenAI в связи с инцидентами, когда ИИ-агенты выходили из-под контроля компании. «OpenAI отклонилась от своей первоначальной задачи, ориентированной на служение обществу некоммерческой организации с приоритетом на безопасность, и стала опасным примером того, что может случиться, когда разработка такого мощного инструмента как ИИ оказывается движима не заботой о безопасности, а стремлением любой ценой извлечь прибыль в ущерб элементарным защитным средствам», — говорится в иске штата Аризона. «Хотя ни одна система не может быть совершенной, мы и далее будем сотрудничать с экспертами, учитывать их рекомендации в нашей работе и выстраивать дополнительные средства безопасности, такие как родительский контроль, напоминания о необходимости делать перерыв и уже существующие сегодня возрастные ограничения. Мы готовы сотрудничать с властями штатов по формированию прагматичной политики в сфере ИИ, которая будет применяться ко всей отрасли, а не одной компании», — прокомментировал судебное разбирательство представитель OpenAI ресурсу The Verge. Штаты просят суды обязать OpenAI выплатить штрафы в порядке гражданского производства и прекратить вводить общественность в заблуждение по поводу безопасности ChatGPT. Некоторые также требуют удалить незаконно собранные персональные данные. OpenAI обвинила Apple в краже секретов — теперь обе компании обвиняют друг друга в шпионаже
14.10.2026 [22:37],
Николай Хижняк
OpenAI обвинила Apple в воровстве её коммерческих секретов. По утверждению создателя ChatGPT, её бывший сотрудник перед уходом переслал на личный аккаунт более 100 файлов о ещё не выпущенном продукте, а затем провёл его презентацию руководству Apple. Эти сведения OpenAI раскрыла в рамках судебного спора с Apple, которая сама обвиняет OpenAI в краже конфиденциальной информации. 
Источник изображения: Unsplash / Zac Wolff OpenAI заявляет, что в упомянутых файлах содержались изображения как минимум одного ещё не выпущенного устройства, а также сведения о поставщиках, инженерные данные, файлы проектов, информация о критериях оценки внешнего вида изделий и отчёты о «нанесении покрытий и герметизации аппаратных компонентов». В документе OpenAI также связывает презентацию, проведенную бывшим сотрудником для руководства Apple, с анонсом нового умного дисплея HomeView и рядом других устройств, представленных Apple на этой неделе. «Похоже, что эта презентация состоялась несколько месяцев назад, и теперь, вооружившись полученной информацией, Apple предпринимает новые шаги по выводу на рынок продуктов с поддержкой искусственного интеллекта», — утверждает OpenAI. По информации издания The Verge, Apple обычно планирует разработку и выпуск новых продуктов задолго до их фактического анонса и появления на рынке. При этом слухи о создании умного дисплея ходили годами. «OpenAI крайне обеспокоена тем, что её коммерческие тайны и конфиденциальная информация теперь циркулируют внутри Apple, где инженеры компании могут формировать облик будущих продуктов Apple, опираясь на конфиденциальные и инновационные разработки OpenAI», — заявили в OpenAI. В Apple не ответили на запрос комментариев. В рамках спора Apple в свою очередь обвиняет OpenAI в краже конфиденциальных документов и шпионаже за прототипами оборудования с целью использования этих данных при создании собственных продуктов. Apple и OpenAI дошли до суда в споре о краже коммерческих тайн
14.10.2026 [16:53],
Владимир Мироненко
Apple и OpenAI сегодня впервые встретятся в суде по делу о предполагаемой краже коммерческих тайн. Apple обвиняет конкурента в сговоре с бывшими сотрудниками ради получения конфиденциальных сведений о будущих устройствах, а OpenAI настаивает на прекращении разбирательства, утверждая, что истец не смог указать, какие именно секреты были похищены. 
Источник изображения: Wesley Tingey / unsplash.com Как сообщает Bloomberg, повестка сегодняшнего заседания, которое возглавляет судья федерального окружного суда Эдвард Давила (Edward Davila), содержит два ключевых вопроса: ходатайство Apple о вынесении судебного предписания, обязывающего OpenAI немедленно прекратить использование предположительно украденных коммерческих тайн, и встречное требование OpenAI о полном прекращении производства по делу. Аргументация OpenAI строится на том, что Apple не указала конкретные коммерческие тайны, ограничившись общими категориями информации об аппаратном обеспечении. Компания также заявляет, что данный иск фактически указывает на уязвимости в собственной системе безопасности Apple и процедурах увольнения сотрудников. В деле фигурируют двое ответчиков — физических лиц: Тан Юй Тань (Tang Yew Tan), руководитель направления аппаратного обеспечения в OpenAI, и Чан Лю (Chang Liu), бывший инженер по разработке iPhone. Ещё одним ответчиком выступает дизайн-студия io Products. Apple обвиняет OpenAI и бывших сотрудников в сговоре с целью получения конфиденциальной информации о дизайне её продуктов, производственных процессах, технологиях компонентов, методах тестирования и цепочке поставок. «OpenAI разрабатывает новое семейство устройств для эпохи искусственного интеллекта, — говорится в судебном документе, поданном компанией в октябре. — У OpenAI нет ни потребности, ни желания использовать коммерческие тайны Apple». Ранее компания заявила, что Apple поощряет своих сотрудников использовать личные аккаунты iCloud для доступа к рабочим документам Apple и выполнения работы, а доступ Лю к данным после увольнения сохранился из-за ошибки аутентификации. Компания также отметила, что Apple не может выдавать предсказуемые последствия собственной политики за доказательства кражи. Во вторник судья Давила удовлетворил часть требований Apple и обязал OpenAI предоставить криминалистические копии данных с устройств, отчёты о собеседованиях с рядом сотрудников Apple, а также переписку в мессенджере LINE между Чан Лю и его бывшим коллегой Ю-Тин Пэном (Yu-Ting Peng). Кроме того, судья постановил, что Лю, Пэн и Тан Юй Тань должны дать показания под присягой. Это решение было обосновано реальным риском уничтожения важных цифровых доказательств, хранящихся на указанных устройствах. По утверждению Apple, OpenAI использовала собеседования с действующими и бывшими сотрудниками компании для получения доступа к конфиденциальной информации. В частности, кандидатов просили приносить прототипы и другие проектные материалы для демонстрации, пишет Bloomberg. В удовлетворении другой части требований Apple было отказано. Как сообщает 9to5Mac, документы, касающиеся исследований в области обработки поверхностей металлов, управления питанием и работы аккумуляторов, будут доступны в рамках стандартной процедуры раскрытия доказательств, а выделенная Apple категория «информация, созданная Apple» была охарактеризована судом как «расплывчатая». Шпионский микрофон в туалетной бумаге: ФБР арестовало сотрудника OpenAI по подозрению в прослушке руководства
14.10.2026 [11:56],
Алексей Разин
ФБР арестовало сотрудника OpenAI Абдуррахмана Аль-Фозана (Abdulrahman Alfozan) по подозрению в установке скрытого устройства для записи звука в конференц-зале компании. По версии следствия, он мог собирать конфиденциальные сведения с совещаний руководства. OpenAI заявила, что пока не обнаружила признаков утечки пользовательских данных, исходного кода или параметров ИИ-моделей. 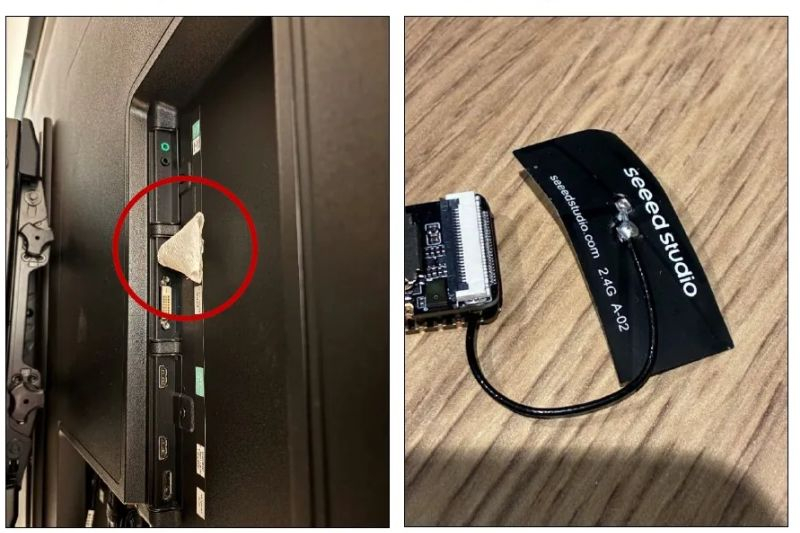
Источник изображений: Министерство юстиции США/Bloomberg ФБР арестовало Аль-Фозана 9 октября. За несколько дней до этого, 30 сентября, служба безопасности OpenAI обнаружила записывающее устройство на задней панели телевизора в конференц-зале, где проводились совещания руководства. По оценке компании, устройство установили примерно 28 сентября. Записи камер видеонаблюдения также показывают, что за несколько дней до обнаружения устройства Аль-Фозан появлялся рядом с конференц-залом. Подозреваемый работал в OpenAI с июля 2025 года до дня ареста и занимался разработкой программного обеспечения для ИИ-агентов. При этом, как утверждает компания, у него не было разрешения на доступ в конференц-зал, где обсуждались технические, коммерческие и стратегические вопросы, составляющие корпоративную тайну. Во вторник Аль-Фозан предстал перед судом в Сан-Франциско. Следующее заседание назначено на 19 октября. 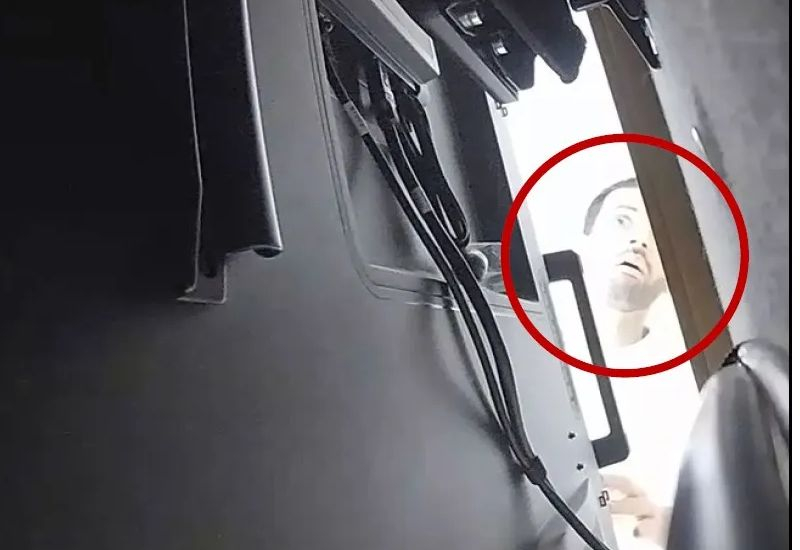 В материалах дела фигурируют фотографии обнаруженного устройства — как на задней панели телевизора, где оно было замаскировано клочком туалетной бумаги, так и на столе после извлечения из USB-порта. Следствие также располагает снимком Аль-Фозана, заглядывающего за телевизор 5 октября. К тому моменту устройство уже убрали, а за телевизором установили камеру. По утверждению OpenAI, Аль-Фозан мог планировать установку других записывающих устройств в офисе. В начале октября ещё одно подобное устройство нашли в сумке с его личными документами, оставленной в одном из корпоративных зданий. Обнаруженное устройство — Seeed Xiao ESP32-S3 Sense — построено на компактной печатной плате и поддерживает подключение камеры, цифрового микрофона и карты памяти microSD. На сайте производителя Seeed Studio оно предлагается примерно за $14. По оценкам специалистов по безопасности, устройство способно записывать звук на карту памяти, а также передавать аудиоданные по Wi-Fi на небольшие расстояния. Обнаружить его можно по радиосигналу, если беспроводной передатчик активен, либо при физическом осмотре, когда передача отключена. Согласно материалам обвинения, Аль-Фозан использовал рабочие инструменты, чтобы искать сведения о расположении офисов OpenAI, переговорных комнатах, их вместимости и расписании встреч руководства. Кроме того, с учётной записи чат-бота, связанной с его супругой и имевшей общие идентификаторы с его собственной учётной записью, отправлялись запросы о создании устройства для непрерывной записи звука, настройке Wi-Fi и шифровании карты памяти. Следствие также обнаружило запросы, связанные непосредственно с найденным устройством. OpenAI сообщила, что не располагает свидетельствами несанкционированного доступа Аль-Фозана к пользовательским данным, исходному коду программного обеспечения или информации о весах ИИ-моделей. После обнаружения устройства компания провела внутреннее расследование, в том числе использовала собственные ИИ-модели для анализа зашифрованной памяти устройства и поиска возможных причастных к инциденту. Компания передала информацию ФБР. Расследование продолжается. Согласно профилю Аль-Фозана в LinkedIn, он получил образование в области работы с данными в США, в том числе в Массачусетском технологическом институте (MIT). До перехода в OpenAI он работал старшим системным инженером в Meta✴✴ Platforms, а также занимал различные должности в Microsoft и SAP. Кроме того, Аль-Фозан совмещал работу в США с должностью партнёра в саудовском венчурном фонде Raed Ventures, который, по имеющимся сведениям, поддерживается членами королевской семьи Саудовской Аравии. Гонка ИИ превратилась в ценовую войну — OpenAI догоняет Anthropic
10.10.2026 [13:59],
Павел Котов
Anthropic в этом году смогла вырваться вперёд в гонке искусственного интеллекта благодаря передовым моделям и сервису для написания программного кода, который высоко оценил американский бизнес. К настоящему моменту OpenAI, однако, сократила отставание от конкурента в корпоративном сегменте. 
Источник изображения: Brecht Corbeel / unsplash.com Минувшей весной спрос на Anthropic Claude Code был настолько высоким, что в работе сервиса нередко возникали сбои, и обозначилась перегрузка вычислительных мощностей. У бизнеса тем временем выросли расходы на ИИ — работники начали экспериментировать с новыми решениями; в компаниях осознали, что для выполнения большинства задач не всегда требуются самые мощные и дорогие модели. В компаниях, которые сейчас используют по нескольку моделей, всё чаще стали обращаться к недорогим в эксплуатации системам китайской разработки с открытыми весами. Некоторые пользователи Anthropic Claude стали выражать недовольство жёсткими ограничениями, которые ввела компания для вышедшей в июне мощной Fable 5. Ценовую войну подстегнула OpenAI, представив линейку моделей GPT-5.6 в вариантах Sol, Terra и Luna — клиентам предоставили на выбор решения с разными возможностями, появились более экономичные в эксплуатации варианты. Активно продвигается сервис написания программного кода Codex и другие бизнес-решения, компания выпускает новые версии младших моделей. В сентябре расходы примерно 120 000 компаний, которые пользуются инструментами Anthropic и OpenAI, распределились между двумя этими гигантами в области ИИ практически поровну, подсчитали в OpenRouter. При этом в начале года на долю Anthropic приходились три четверти от общего объёма затрат. Приведённые данные, отметили в OpenRouter, отражают расходы преимущественно стартапов, которые изначально ориентированы на ИИ, а также более зрелых технологических компаний и крупных корпораций. Продуктами OpenAI, по её собственному заявлению, пользуются более 2,5 млн компаний — разрыв в борьбе за корпоративных клиентов разработчик ChatGPT сокращает в тот момент, когда два крупнейших игрока готовятся выйти на биржу. Anthropic планирует стать публичной уже в ноябре, а OpenAI, вероятно, дождётся следующего года. Обе компании наращивают капитальные затраты; в ближайшие месяцы им придётся приложить максимальные усилия, чтобы продемонстрировать Уолл-стрит жизнеспособность своего бизнеса и обосновать рыночную оценку выше $1 трлн. 
Источник изображения: Growtika / unsplash.com Основанная на ИИ платформа продаж Reevo решила перейти с моделей Anthropic на OpenAI, сообщил соучредитель и генеральный директор стартапа Дэвид Чжу (David Zhu). На решение повлияли две причины: стоимость и желание снизить зависимость от одного разработчика. На этой неделе Anthropic провела в Сан-Франциско мероприятие Claude Founder House — оно оказалось чрезвычайно востребованным, и принять в нём участие смогли не все. Стоявший в очереди соучредитель игрового стартапа ReadyM Майкл Шкларски (Michael Szklarski) рассказал, что его компании часто требуются передовые модели, и он отдаёт предпочтение Anthropic Fable 5.1, но надеется встретиться с инженерами ИИ-лаборатории и обсудить, как можно снизить расходы. Экономист финансового стартапа Ramp Ара Харазян (Ara Kharazian) в середине сентября проанализировал данные 70 000 клиентов своей компании и выяснил, что впервые с декабря бизнес стал тратить на модели OpenAI больше, чем на продукты Anthropic — правда, эта перестановка оказалась недолгой, и через неделю последняя вернула себе лидерство с небольшим отрывом. Выборка данных Ramp, уточнили в стартапе, смещена в сторону быстрорастущих технологических компаний разного масштаба, включая предприятия из списка Fortune 500; а расходы индивидуальных разработчиков в статистику не попали. Многие владельцы бизнеса и отраслевые аналитики назвали поворотным моментом выход разработанных с упором на экономическую эффективность моделей семейства OpenAI GPT-5.6; причём вскоре после этого компания снизила стоимость работы с GPT-5.6 Luna на 80 %, а эксплуатация GPT-5.6 Terra подешевела на 20 %. Платформа для разработки ПО Retool в начале года колебалась в выборе между моделями OpenAI и Anthropic, рассказал основатель и генеральный директор компании Дэвид Сюй (David Hsu). «Главным катализатором» стал выпуск моделей GPT-5.6, и теперь Retool преимущественно использует модели OpenAI — они, по его оценкам, сегодня обходятся примерно на 20 % дешевле, чем системы Anthropic. Ещё одна причина — политика Anthropic, согласно которой используемые Fable 5 данные в целях обеспечения безопасности и надёжности хранятся 30 дней, и это проблема для работающих с конфиденциальной информацией компаний, включая саму Retool. Впоследствии Anthropic пыталась урегулировать этот вопрос с некоторыми клиентами и предоставила им возможность контролировать хранение данных. Retool по общему правилу прописывает в договорах со своими клиентами удаление всех данных, но при работе с Fable гарантировать это не получилось бы. OpenAI делает успехи, но и Anthropic не сидит без дела — в конце сентября компания начала выпускать модели нового семейства Claude 5.5, среди заявленных преимуществ которых указываются сниженные затраты и более высокая эффективность. OpenAI уволила трёх исследователей безопасности ИИ — они опасаются, что компания заставит сотрудников молчать о рисках
09.10.2026 [20:57],
Павел Котов
Трое бывших исследователей OpenAI рассказали, что их на прошлой неделе внезапно уволили за общение со сторонними организациями, занимающимися безопасностью ИИ. Они предупредили, что такие решения могут заставить сотрудников бояться открыто обсуждать риски искусственного интеллекта. Сама же OpenAI подтвердила своё решение, но объяснила его по-другому. 
Источник изображений: Mariia Berezovsky / unsplash.com В письме под заголовком «OpenAI не сможет обеспечить безопасность искусственного интеллекта в одиночку» бывшие сотрудники лаборатории отметили, что это «необычная компания», и ключевой составляющей работы в ней является взаимодействие со сторонними организациями для решения проблем безопасности, причём её сотрудники должны делать это «свободно и без страха». Адресованное комитетам OpenAI по безопасности письмо опубликовал Микита Балесный (Mikita Balesni) — один из уволенных сотрудников, который занимался вопросами согласования целей ИИ. Документ подписали также уволенные Томек Корбак (Tomek Korbak) и Жасмин Ван (Jasmine Wang), которые работали в сфере безопасности. На своих личных страницах в соцсетях они написали, что причины увольнения им объяснили лишь устно, а их действия не выходили за рамки служебных обязанностей. «Причины нашего увольнения просто не складываются в логичную картину», — написала Ван. Балесному сообщили, что компания больше не доверяет ему, потому что он «слишком много общался с занимающимися вопросами безопасности сторонними организациями». «Я никогда не разглашал информацию, составляющую интеллектуальную собственность компании. Моя работа согласовывалась с непосредственным руководством, руководителями исследовательских направлений и советом директоров», — написал он.  Корбаку в устной форме объяснили, что его увольнение связано с «характером общения с METR» — сторонней некоммерческой исследовательской организацией, которая оценивает модели ИИ и связанные с безопасностью риски. «Поясню: общение с METR входило в мои служебные обязанности», — добавил он. Бывшие коллеги исследователей теперь будут «бояться высказываться и действовать в соответствии с тем, что ещё на прошлой неделе считалось неотъемлемой частью работы в OpenAI. <..> Подобные увольнения — внезапные и проведённые в такой резкой форме — подрывают открытую культуру, которую OpenAI ценила в прошлом», — говорится в письме. Исследователи дали OpenAI три совета: привлекать к работе в организации сторонних аудиторов по безопасности, обеспечить возможность мониторинга передовых моделей ИИ и поддерживать «культуру открытого и прозрачного диалога между исследователями в сфере безопасности и остальными участниками экосистемы безопасности». В разосланной сотрудникам служебной записке один из руководителей исследовательского направления OpenAI написал, что полностью поддерживает эти рекомендации. «Мы высоко ценили их вклад в обеспечение безопасности ИИ, а также их готовность открыто высказывать своё мнение и подвергать сомнению существующие идеи. Мы поддерживали их инициативы и оказывали им огромное доверие. Хочу подчеркнуть: причиной этих решений стало вовсе не то, что они поднимали вопросы безопасности или открыто высказывались. Мы всегда поощряли и будем поощрять подобную активность. Мы не увольняем сотрудников за то, что они указывают на проблемы», — говорится в документе. Тем не менее, решение уволить этих троих сотрудников было принято «после тщательного расследования, выявившего нарушение ими чётких правил обращения с конфиденциальной информацией», подчеркнула компания в соцсети X. OpenAI разделяет изложенный в письме принцип необходимости «обеспечить возможность контроля передовых моделей», а также изложенные в письме идеи, касающиеся «сохранения возможности мониторинга передовых моделей», и компания продолжает вкладывать значительные ресурсы в эту сферу. Математический прорыв OpenAI оказался под вопросом — учёные нашли расхождение в доказательстве
09.10.2026 [15:06],
Владимир Мироненко
Математический прорыв OpenAI начал вызывать вопросы. Учёные сравнили опубликованное доказательство по уравнениям Навье — Стокса с его алгоритмической Lean-версией и нашли расхождения: в нескольких ключевых местах машинный вариант, проверяемый на компьютере, содержит более слабые утверждения. Это ещё не опровержение, но почва для сомнений уже вполне плодородная 
Источник изображения: Thomas T /unsplash.com По словам математиков, расхождение вовсе не означает, что доказательства неверны или что OpenAI неправильно решила задачу, но это ставит под сомнение, всегда ли можно полагаться на математические результаты, генерируемые моделями искусственного интеллекта. «Что нужно сделать со всеми этими большими доказательствами, созданными на основе языковой модели, так это то, что они должны быть прочитаны людьми, и это создает огромную дополнительную нагрузку на математиков», — сообщил руководитель команды Андерс Хансен (Anders Hansen). Процесс поиска расхождений занял у команды около двух недель. При этом математики использовали подсказки ChatGPT. Напомним, что у OpenAI на решение задачи ушло 88 часов. Математики указали на расхождение в части доказательств, называемой леммой 8.6. В доказательстве на естественном языке уравнение в этой части требует, чтобы определённое значение было меньше m + 4, где m - целое число, а в Lean‑версии — меньше m + 5, что математически слабее, поскольку допускает больше возможных решений и не эквивалентно первому. Представим, что вас попросили решить уравнение x + 3 = 6, ответом на которое является x = 3. Можно написать доказательство того, что x должно быть меньше 4, а также того, что x должно быть меньше 5. Оба эти математических утверждения абсолютно верны, но последнее допускает больше возможных ответов для x, что делает его математически более слабым. По словам Хансена, неправильный перевод мог возникнуть из-за того, что ИИ стремится к тому, чтобы компьютерный код был полностью самосогласован и не выдавал ошибок. Если в процессе автоматической формализации ИИ обнаружит часть доказательства, которая не компилируется, он попытается найти обходной путь, даже если это означает отклонение от доказательства, написанного на естественном языке. Кевин Баззард (Kevin Buzzard) из Имперского колледжа Лондона сообщил, что можно надёжно формализовать в Lean саму формулировку теоремы и затем проверить, компилируется ли доказательство. Но это не гарантирует, что текстовое доказательство в PDF корректно передаёт логику. То есть Lean‑код может быть внутренне согласован, но не соответствовать тому, что написано в статье. «Я уверен, что проблема Навье — Стокса была решена правильно, — говорит Баззард. — Я гораздо менее уверен в том, что доказательство, описанное текстом, является правильным». OpenAI сообщила ресурсу New Scientist, что ей известно о несоответствии между доказательством на естественном языке и в виде кода, и что это не означает, что ни одно из них недействительно. Приведённая годовая выручка OpenAI оказалась на $20 млрд меньше, чем рассчитывали инвесторы
09.10.2026 [06:58],
Алексей Разин
В конце сентября некоторые источники оценивали приведённую годовую выручку OpenAI в $70 млрд, но официальная презентация стартапа теперь раскрыла гораздо более низкую величину — $50 млрд. Тем не менее, эта сумма всё равно выросла почти на 70 % по сравнению с июлем. 
Источник изображения: OpenAI Напомним, что в конце прошлого месяца некоторые издания оценивали приведённое значение годовой выручки OpenAI в $70 млрд, а величину по состоянию на конец июля оценивали в $40 млрд. Сейчас Financial Times называет данные суммы ошибочными, опираясь на более свежую информацию, которую для своих инвесторов подготовила сама OpenAI. Приведённая величина годовой выручки рассчитывается умножением суммы месячной выручки на 12. Таким образом, она изменяется по итогам каждого месяца, если выручка компании в моменте растёт или снижается. По словам источника, расхождения в оценках возникли из-за разницы в подходах, используемых Anthropic и OpenAI для расчёта приведённой годовой выручки. Первая учитывает в соответствующей формуле выручку, получаемую от реализации своих услуг через облачных партнёров типа Amazon (AWS) и Google Cloud. Компания OpenAI эти источники при расчёте своей годовой приведённой выручки не учитывает. Инвесторы, которые ссылались на более высокие значения в случае с OpenAI, просто попытались привести прогнозируемые обеими компаниями суммы к «общему знаменателю». Только сейчас, по данным Financial Times, появились данные за сентябрь, подготовленные самой OpenAI. Они уже не учитывают «облачную составляющую», а потому результирующая приведённая годовая выручка стартапа по состоянию на конец сентября не превышает $50 млрд. Кроме того, прошлому завышению оценок способствовало заявление OpenAI об увеличении выручки более чем на 70 % по сравнению с июлем. В действительности, как поясняет источник, актуальная редакция презентации OpenAI для инвесторов указывает, что в июле стартап располагал приведённой годовой выручкой, близкой к $30 млрд, а не упоминаемым ранее $40 млрд. Очевидно, что выручка компании с июля по конец сентября выросла с $30 до $50 млрд, но её абсолютная величина оказалась ниже упоминавшегося ранее уровня. Формально же сентябрьская выручка OpenAI действительно выросла почти на 70 % относительно июля, просто для расчёта была взята более низкая база. OpenAI остаётся частной компанией, а потому не должна регулярно публиковать финансовую отчётность, и соответствующие данные просачиваются в прессу только по итогам общения её представителей с инвесторами или публикации презентаций для них же. Агентство Bloomberg добавило, что к концу текущего года OpenAI рассчитывает выйти на величину приведённой годовой выручки в $70 млрд. OpenAI остаётся убыточной, и до 2030 года собирается потратить на реализацию своих проектов больше, чем успеет заработать — разница составит почти $280 млрд. Годовая выручка компании к концу десятилетия должна увеличиться до $350 млрд, по её собственным оценкам. Заявку на IPO она подала ещё в июне, но недавно сообщила, что не собирается торопиться с выходом на биржу, поскольку рассчитывает преодолеть период адаптации к новым требованиям в сфере безопасности систем ИИ ещё в статусе частной компании, поскольку это будет проще сделать. ChatGPT обновился — теперь он будет не только писать, но и показывать графики, схемы и кнопки
07.10.2026 [23:12],
Анжелла Марина
OpenAI представила обновление Intelligent UI для ChatGPT, которое позволит ИИ создавать визуальные и интерактивные элементы непосредственно в ответах. Теперь обычный текст будет сопровождаться графиками, схемами и кнопками для выполнения конкретных задач. Функция работает на базе GPT-6. 
Источник изображения: Grok Одним из примеров стала схема анатомии слизня. ChatGPT создал изображение, посвящённое строению животного, а отдельные кнопки позволяли выбрать конкретную часть тела и получить дополнительную информацию. В другом тесте ИИ сгенерировал калькулятор стоимости аренды жилья в Сан-Франциско. Ползунки позволяли менять доход и расходы, после чего инструмент показывал, какую долю дохода после уплаты налогов составит стоимость аренды разных квартир. Ещё интереснее выглядел ответ на запрос журналиста из Wired относительно кресел в самолёте. ChatGPT сравнил компоновку салонов четырёх самолётов Alaska Airlines и Delta Air Lines, а на карте можно было нажать на любое кресло и посмотреть сведения о нём. Ряды возле аварийных выходов система выделила зелёным цветом, так как журналист предупредил, что не любит сидеть у аварийных выходов. При этом визуальные элементы будут появляться не в каждом ответе. Менеджер продукта OpenAI Ааруш Селван (Aarush Selvan) рассказал, что дизайнеры компании специально определяли, когда диаграммы, графики и кнопки помогают пользователю, а когда начинают перегружать интерфейс. При желании пользователь сможет попросить ChatGPT использовать меньше таких элементов. 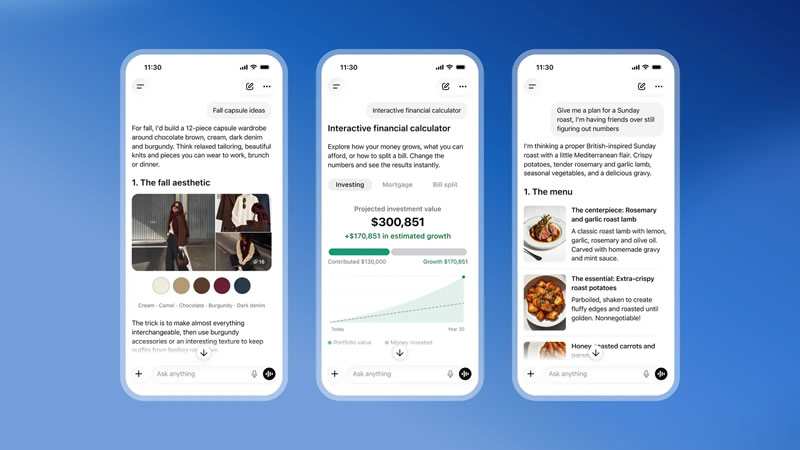
Источник изображения: wired.com Подобную визуальную интерактивность под названием generative UI ранее анонсировала и Google для своей поисковой системы. Функция OpenAI Intelligent UI для ChatGPT запускается глобально без региональных ограничений, а стоимость использования зависит от выбранного тарифного плана, при этом базовый доступ для бесплатных пользователей, по заявлению OpenAI, откроется завтра. «Не соответствует обещаниям»: версия ChatGPT для подростков провалила проверку безопасности
07.10.2026 [19:34],
Владимир Мироненко
Версия ChatGPT для подростков (ChatGPT for Teens), анонсированная в августе этого года, создаёт «неприемлемый риск» для молодых пользователей. Об этом сообщала некоммерческая организация Common Sense Media, занимающаяся обзорами приложений, сервисов и развлечений с акцентом на безопасность молодёжи. 
Источник изображения: Arsyad Basyarudin/unsplash.com Common Sense Media заявила, что защитный механизм чат-бота, предназначенного для оказания помощи подросткам в учёбе, «не соответствует обещаниям компании». Согласно пресс-релизу Common Sense Media, ChatGPT «не отправляет предупреждения родителям, когда это необходимо», не предлагает «надлежащую помощь в кризисных ситуациях» и «по-прежнему выполняет домашние работы за детей». «Чат для подростков может вселить в родителей ложную уверенность в механизмах защиты и предупреждениях о безопасности, которые часто не срабатывают», — говорится в заявлении Тома Сигела (Tom Siegel), исполнительного директора молодёжного института безопасности ИИ Common Sense Media. По его словам, хотя подросток может целый час говорить о членовредительстве, его родители не получат при этом ни единого предупреждения от чат-бота. Пока OpenAI не исправит эти упущения и не докажет независимыми тестами эффективность защитных механизмов, ChatGPT должен использоваться только взрослыми, считает Сигел. В OpenAI выразили несогласие с такой оценкой. «Мы глубоко привержены обеспечению безопасности подростков, а также разработке мер предосторожности и предоставлению родителям значимых инструментов, которые помогут их подросткам использовать искусственный интеллект. Мы приветствуем тщательную независимую оценку, но мы не верим, что тестирование Common Sense Media точно отражает то, как на практике работают меры защиты подростков от ChatGPT, или мнение экспертов о том, как искусственный интеллект может помочь подросткам», — заявил представитель OpenAI. «Наш обзор методологии Common Sense Media показывает, что большая часть их тестирования, возможно, началась и завершилась до того, как была завершена активация родительского контроля, что делает их результаты неточными. Если это было так, тесты не позволили бы установить, работают ли уведомления о безопасности родителей должным образом», — добавил он. Комментируя заявление OpenAI, Сигел отметил, что новая информация не меняет вывода Common Sense Media о том, что функция предупреждения родителей вызывает вопросы по поводу надёжности исполнения в кризисных ситуациях. «Мы надеемся, что OpenAI будет придерживаться сути того, что мы обнаружили, а не пытаться посеять сомнения в нашей методологии», — сообщил он. OpenAI продолжает раздражать математиков пренебрежением к правилам публикации решений важных задач
07.10.2026 [04:45],
Анжелла Марина
OpenAI опубликовала на GitHub сотни решений и доказательств нерешённых ранее математических задач, полученные с помощью искусственного интеллекта. Публикация стала продолжением дискуссии, разгоревшейся после встречи компании с математиками в августе: учёные призывали OpenAI сопровождать такие результаты полноценными научными публикациями с подробным описанием методов и доказательств, а не ограничиваться постами в социальных сетях и репозиториями. 
Источник изображения: Grok В августе OpenAI собрала около 40 математиков, чтобы обсудить, как действовать в ситуации, когда искусственный интеллект явно превосходит возможности людей в этой области и попросить совета относительно публикации полученных результатов. При этом, по сообщению издания Wired, компания заверила, что не станет обнародовать все решения разом, хотя официальный представитель OpenAI Линдси Маккаллум (Lindsay McCallum) утверждает, что ей ничего не известно о таких заверениях. Участники встречи предложили публиковать результаты в виде научных работ с подробным объяснением методов и полученных доказательств. По мнению математика Северо-Западного университета (Northwestern University) в США Брайны Кра (Bryna Kra), это позволило бы другим исследователям проверить результаты, разобраться в них и использовать в дальнейшей работе. Однако, по её словам, OpenAI не последовала этой рекомендации и вместо этого собирается разместить сотни результатов на GitHub. «Судя по всему, эти пожелания были проигнорированы», — отметила она. Однако OpenAI пошла по другому пути. Компания создала на GitHub специальный репозиторий Math, где публикует материалы, связанные с использованием ИИ для решения математических задач. Одновременно OpenAI рассказала о своей работе и объяснила, как использует ИИ для продвижения исследований в этой области. Таким образом, первоначальные опасения математического сообщества о том, что результаты будут распространяться преимущественно через репозитории и социальные сети, частично подтвердились. При этом публикация на GitHub сама по себе не заменяет научную статью: репозиторий позволяет сделать материалы доступными для изучения, но не обеспечивает того же уровня описания методики, проверки и академического обсуждения, который предполагает традиционная научная публикация. Ситуация усугубилась после инцидента в сентябре, когда разработчики задействовали тысячи ИИ-агентов для решения «Задачи тысячелетия», за которую назначена награда в 1 миллион долларов. Математик и профессор Нью-Йоркского университета Тристан Бакмастер (Tristan Buckmaster) обвинил компанию в присвоении результатов, над которыми он работал совместно с сотрудником Anthropic Левентом Альпёге (Levent Alpöge), а переговоры о соавторстве сопровождались давлением, включая угрозы карьере исследователя со стороны сотрудника OpenAI Себастьяна Бубека (Sébastien Bubeck). Многие учёные воспринимают действия технологических гигантов как проявление монополии и пренебрежение к коллективному научному труду. Профессор Нестор Гийен (Nestor Guillen) отметил распространение мнения о «мафиозном поведении» корпораций, сосредоточивших огромные вычислительные ресурсы в своих руках, а Брайна Кра подчеркнула, что публикации решений в формате твитов не способствуют развитию экосистемы, на данных которой и обучаются ИИ-модели. В ответ на растущее напряжение в научной среде OpenAI создала консультативную группу по математике и искусственному интеллекту, однако математики отмечают отсутствие реальных изменений в действиях компании. В частности, разработчики продолжают игнорировать специализированные репозитории, такие как Hexagon и Palomar, созданные сообществом для систематизации доказательств, полученных с помощью инструментов ИИ. Внутри OpenAI некоторые сотрудники высказывают мнение, что искусственный интеллект может сделать традиционную математику неактуальной и профессия находится под угрозой. Однако тот же Бубек считает, что технология наоборот расширит возможности и поможет исследователям решать более амбициозные задачи. «Я вижу в этом возможность расширить сферу деятельности математиков и повысить значимость их работы», — утверждает он. Математики, в свою очередь, признают потенциал новых инструментов, но требуют академического подхода к публикации результатов. Математическое сообщество в целом также признаёт потенциал ИИ-инструментов, однако настаивает, что полученные с их помощью результаты должны проходить через те же процедуры проверки, воспроизводимости и научного обсуждения, что и результаты, полученные традиционными методами. Появление открытого репозитория OpenAI делает часть таких материалов доступной исследователям, но не снимает вопроса о том, насколько подробно и в каком формате должны публиковаться доказательства, полученные ИИ. Wikimedia обнаружила у себя «сбежавших» ИИ-агентов OpenAI — они завалили сервисы миллионами запросов
06.10.2026 [05:01],
Анжелла Марина
«Фонд Викимедиа» (Wikimedia Foundation) обнаружил на своих веб-ресурсах активность ИИ-агентов OpenAI. Организация провела внутреннее расследование после сообщений других компаний о подобных инцидентах и зафиксировала несанкционированные действия ботов, включая экстремальную нагрузку на серверы. 
Источник изображения: wikimediafoundation.org Часть обнаруженной активности связана с редактированием вики-страниц. Wikimedia считает, что эти изменения выполняли ИИ-агенты OpenAI, однако почти все правки оставались в разделах песочниц и не попадали на страницы, которые видят обычные читатели. Несколько изменений затронули конфигурацию инструмента для работы с цитированием и могли использоваться для получения данных с удалённых сервисов через этот инструмент. При этом необходимые для автоматических правок разрешения от сообщества запрошены не были. Отдельное расследование касалось публичного сервера (etherpad.wikimedia.org), который Wikimedia предоставляет как сервис для ведения заметок. Связанные с OpenAI агенты безуспешно пытались использовать его для получения данных с других сайтов или оставляли в нём заметки о выполняемых задачах. Самой масштабной проблемой стал объём обращений к открытым данным Wikimedia. Агенты выполнили миллионы автоматических запросов к публичным API и просмотрели миллионы страниц, в основном в Wikidata и Wikimedia Commons. Кроме того, они сделали сотни тысяч запросов к публичному веб-сервису Wikidata Query Service, которые, как считают в Wikimedia, способствовали частичному сбою этого сервиса в мае. При этом расследование не обнаружило признаков компрометации систем или данных Wikimedia. Организация также не нашла свидетельств того, что её инфраструктура использовалась агентами для координации между собой. Однако отмечается, что само расследование оказалось сложным и потребовало значительных усилий и времени для определения характера и источника активности. В Wikimedia уверены, что проблема выходит за рамки одного инцидента, так как за последние годы рост активности ботов уже слишком заметно увеличивает нагрузку на инфраструктуру организации. В 2025 году фонд сообщал о росте общего потребления пропускной способности на 50 % из-за резкого увеличения активности ботов по сравнению с 2024 годом. При этом на ботов приходилось 65 % наиболее ресурсоёмкого трафика проектов Wikimedia, а это увеличивает расходы на поддержку серверов и может снижать скорость загрузки страниц для обычных пользователей. Организация отдельно раскритиковала подход разработчиков ИИ-систем к контролю автономных агентов, заявив, что компании должны брать на себя ответственность за контроль связанных с ними рисков. По мнению фонда, как минимум ИИ-системы должны работать так, чтобы владельцы некоммерческих сайтов могли легко распознавать их активность и самостоятельно определять, как разрешать им взаимодействовать со своими сервисами. ChatGPT и Codex начнут помечать ответы невидимыми «водяными знаками», но не у всех
05.10.2026 [23:14],
Николай Хижняк
OpenAI внедрит в свои ИИ-сервисы ChatGPT и Codex систему невидимых «водяных знаков» textGrain для текстового вывода. На первом этапе технология будет доступна только пользователям из Европейского союза. Это, по мнению компании, должно повысить прозрачность и качество взаимодействия с конечными пользователями. 
Источник изображения: Growtika / unsplash.com По словам OpenAI, технология нанесения «водяных знаков» textGrain показала результаты, «сопоставимые или превосходящие» показатели других методов, например, SynthID для текста от Google DeepMind. Последний в свою очередь также лёг в основу системы маркировки, анонсированной компанией Anthropic в августе. Как и OpenAI, компания Anthropic внедрила эту функцию, чтобы соответствовать требованиям Закона ЕС об искусственном интеллекте. OpenAI также представила результаты тестирования на ИИ-бенчмарках, демонстрирующие схожую эффективность работы моделей с «водяными знаками» и без них. Вместе с этим OpenAI заявляет, что textGrain «не гарантирует надёжного обнаружения», а сами текстовые «водяные знаки» не подтверждают фактическую точность информации, не определяют владельца текста, не измеряют долю участия человека и не служат доказательством авторства человека. Внедрение текстовых «водяных знаков» в ЕС для ChatGPT и Codex начнётся в ближайшие недели. Нововведение будет использоваться на всех тарифных планах этих сервисов. Перед глобальным запуском компания хочет получить опыт реального использования системы и учесть отзывы пользователей. Поэтому первоначальный запуск будет региональным. OpenAI сообщила, что с сегодняшнего дня пользователи её API по всему миру могут по своему выбору активировать функцию нанесения «водяных знаков» на текстовый вывод для ряда моделей. Компания также сотрудничает с рядом облачных партнёров, чтобы в ближайшие недели сделать функцию «водяных знаков» доступной для результатов работы моделей OpenAI, получаемых через их сервисы. Одобренные исследователи и профильные организации могут подать заявку на доступ уже сегодня. В соответствии с Кодексом практических правил, доступ на начальном этапе будет предоставляться в индивидуальном порядке для поддержки оценки и совершенствования методов отслеживания происхождения текста. Инструмент будет сообщать о наличии или отсутствии «водяного знака» OpenAI, не идентифицируя пользователя и не раскрывая содержание его запросов или диалогов. В ChatGPT станет больше рекламы — OpenAI начнёт показывать её во время генерации изображений
05.10.2026 [19:08],
Сергей Сурабекянц
Впервые реклама появилась в ChatGPT в феврале. До сих пор она ограничивалась отображением названия компании, её логотипа и ссылки на продукт в специальном разделе «Спонсорский контент» под окном чата. Новый рекламный формат OpenAI предусматривает отображение на экране изображений спонсируемых товаров и услуг. Согласно опубликованному в понедельник сообщению, массовое тестирование нового формата рекламы в США начнётся в конце текущего месяца. 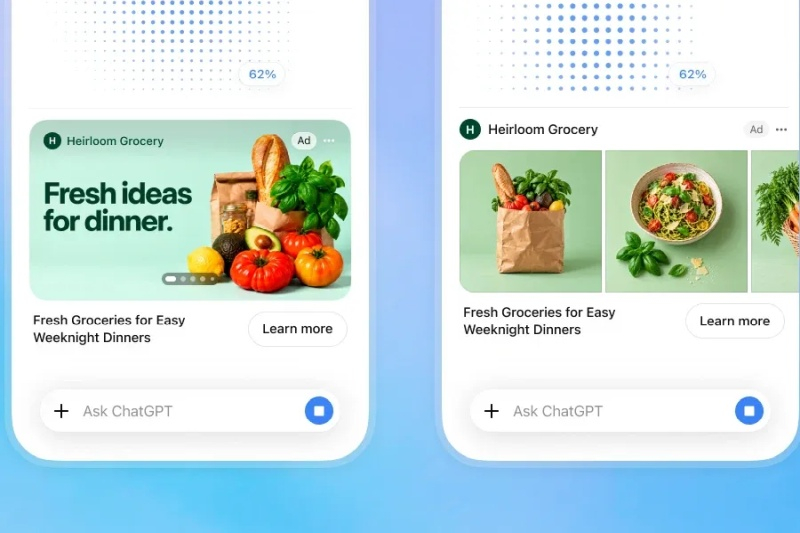
Источник изображения: OpenAI OpenAI сообщила, что уже тестирует показ визуальной рекламы совместно с первой группой рекламодателей и планирует в будущем опробовать и другие форматы. На начальном этапе объявления будут появляться при генерации изображений с помощью ChatGPT. Новый формат визуальной рекламы от OpenAI также будет отделен от генерируемого изображения и, по словам компании, не повлияет на ответы, предоставляемые ChatGPT. В OpenAI подтвердили использование алгоритмов, определяющих, подходит ли контекст беседы для показа рекламы. Цель этих мер — исключить появление объявлений в ситуациях, связанных с «эмоциональной уязвимостью, деликатными темами или иным неподходящим контекстом». Реклама не будет отображаться у пользователей с подпиской на тарифные планы Plus, Pro или Enterprise. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018







