Опрос
|
реклама
Быстрый переход
ИИ научился писать более по-человечески — но обзавёлся новыми словами-паразитами
02.10.2026 [13:14],
Павел Котов
Тексты, созданные большими языковыми моделями искусственного интеллекта, сейчас встречаются повсеместно, и у людей появилось желание научиться их распознавать. Ранее ИИ часто использовал длинное тире или предлагал нечто «исследовать глубже» — эти маркеры уже ушли в прошлое, но чат-боты сохранили некоторые речевые пристрастия, показало исследование маркетинговой компании Graphite. 
Источник изображения: Igor Omilaev / unsplash.com Сейчас у каждой модели ИИ отмечаются собственные уникальные особенности. Специалисты Graphite выделили 13 000 фраз, которые встречались в созданном ИИ контенте как минимум вдвое чаще, чем в написанных человеком текстах — такие фразы исследователи определили как маркеры. Примечательно, что модели Anthropic Claude всё больше генерируют похожий на человеческий текст, а системы OpenAI GPT напротив, отдаляются от естественного для человека распределения слов. В качестве контрольной группы исследователи взяли массив из 10 000 статей, опубликованных до выхода ChatGPT — их явно писали люди. Авторы проекта поручили различным моделям ИИ переписать эти статьи на основе кратких аннотаций, чтобы исключить влияние исходного текста. Получив сопоставимые образцы текста от людей и каждой из моделей, в Graphite сравнили частоту употребления определённых слов и фраз и начали выявлять общие закономерности построения предложений. Характерным маркером модели Anthropic Claude Opus 5.5 оказалось слово «надёжный» («dependable») — у неё оно встречается в 23 раза чаще, чем в написанных людьми текстах. Она стала избегать конструкции «это не X, а Y» (it’s not X, it’s Y), но всё ещё использует вариант «это больше, чем X — это Y» (is more than an X, it’s a Y). Фраза «это важно» (this matters) встречается в 116 раз чаще, чем у человека, а оборот «почему X важно» (why X matters) — в 92 раза чаще. 
Источник изображения: Milad Fakurian / unsplash.com Собственный набор отличительных признаков есть у OpenAI GPT-6 Astra. Эта модель любит описывать «другое измерение» (another dimension) обсуждаемого предмета и отмечать, что какое-либо действие «может обеспечить» (may provide) или «способно дать» (can provide) определённое преимущество. Наиболее ярким маркером модели исследователи считают «корректирующую формулировку»: когда некий предмет определяется как «не просто X» (not simply X) или подаётся как альтернатива — «вместо того, чтобы полагаться на X» (rather than relying on X). Подобные формулировки в текстах Astra встречаются более чем в сто раз чаще, чем у людей. Ранее характерным признаком составленных ИИ текстов было обилие длинного тире. Разработчики учли это, и в изученных Graphite образцах текстов модель Claude Opus 5.5 использовала данный знак препинания на 99 % реже, чем Opus 5. OpenAI GPT-6 Astra употребляет его на 88 % реже, чем люди, а Google Gemini 3.1 Pro отказалась от длинного тире почти полностью. В целом число речевых маркеров не снижается — на смену одним приходят другие, «и у каждой версии модели они свои», говорят исследователи. Разработчики действительно стремятся добиться у ИИ максимально приближенного к человеческому стиля письма — такие заявления делала Anthropic с выпуском Opus 5.5 и OpenAI, когда представила GPT-6 Sol и Luna. Но едва ли у ИИ-лабораторий получится полностью искоренить подобные речевые предпочтения, считают в Graphite. Примечательно, что если ИИ-модели стремятся общаться более по-человечески, то язык человека становится всё более похожим на генерируемый чат-ботами текст — недавно на это пожаловались представители сразу нескольких профессий. ChatGPT заразил людей своим языком — ИИ-клише незаметно проникли в повседневную речь
30.09.2026 [18:29],
Павел Котов
Представители разных профессий рассказали газете The Wall Street Journal, как стали замечать за собой, что пользуются в повседневной речи языком искусственного интеллекта — либо строгими формулировками, которые используются в запросах, либо эпитетами, которыми щедро приправляют свои ответы большие языковые модели. 
Источник изображения: Brey / unsplash.com Партнёр-учредитель венчурной фирмы из Стокгольма Сара Виммеркранц (Sara Wimmercranz) поймала себя на том, что начала рабочее совещание с «контрастного фрейминга» (contrast framing) — излюбленного речевого приёма чат-ботов. «Это не утреннее совещание. Это перезагрузка», — заявила она. Госпожа Виммеркранц, по её собственному признанию, усвоила столько сгенерированного ИИ контента, что теперь он сам собой слетает у неё с языка. Разговоры в офисе всё чаще напоминают беседы с OpenAI ChatGPT или Anthropic Claude: шведской культуре чужды восторженные похвалы, но люди с удивлением начинают называть друг друга «блестящими» и «очень умными», как это делают склонные к лести чат-боты. Кадровик из стартапа в районе Залива Сан-Франциско Уилл Барнетт (Will Barnett) считает, что говорит всё ещё как человек, зато при переписке по электронной почте и в корпоративном мессенджере уже ощущает влияние ИИ — в его тексты пробрались некоторые формальность и безликость, не характерные ему прежде. В какие-то моменты он ловит себя на мысли, что написанные им самим рабочие тексты с тем же успехом можно было поручить составить ИИ — результат был бы тем же; и, похоже, это ИИ делает человека похожим на себя, а не наоборот. В итоге господин Барнетт начал прилагать усилия, чтобы отредактировать свои сообщения и сделать так, чтобы они не были похожи на сгенерированный ИИ-контент. 
Источник изображения: Helena Lopes / unsplash.com Консультант по вопросам ИИ Элли Миллер (Allie K. Miller) рассказала, что в ходе недавнего совещания с основателями стартапов разговор зашёл о «языке пещерного человека» — так обозначается предельно прямой и лаконичный стиль составления запросов к ИИ. Участники совещания признались, что эта манера общения проникает в их повседневную жизнь, а иногда люди ловят себя на том, что в жизни им не хватает маркированного списка. Госпожа Миллер научилась ценить тексты, написанные до наступившей в конце 2022 года эпохи ChatGPT, и слова, которые чат-боты выдают нечасто, — например, слово «какофония». ИИ хорошо реагирует на чёткую формулировку целей, и люди пытаются это перенять: когда один человек пускается в рассуждения, его могут оборвать вопросом: «Какова цель?» В результате человек начинает говорить конкретнее и быстрее. И это помогает ИИ-агентам, фиксирующим ход встречи, делать более качественные сводки. Сотрудник ИИ-стартапа из Сан-Франциско Дэниел Волковиц (Daniel Wolkowitz) говорит, что ему всё труднее отличать сообщения в мессенджере или электронной почте, написанные человеком, от написанных ИИ, да и сам он неосознанно начал писать в духе нейросети. «У меня такое чувство, будто атрофируется мозг», — признался он. Житель Сан-Франциско и глава ИИ-стартапа Дипан Мехта (Deepan Mehta) завёл в офисе нечто вроде штрафной копилки: каждый раз, когда работник компании в устной речи употребляет характерное для ИИ выражение, ему ставят на доске отметку — проигравший в конце недели угощает коллег. Руководитель некоммерческой организации Дэвид Бохеган (David Bohegan) из Вашингтона говорит, что ИИ позаимствовал лексику у профессиональных управленцев и юристов с классической бизнес-подготовкой. Он сам так говорит уже много лет, и только сейчас люди стали лучше его понимать. Работающая уже двадцать лет в области связей с общественностью Анджела Нибс (Angela Nibs) всегда пыталась отучить руководителей компаний употреблять в речи корпоративный новояз и профессиональный жаргон. И с появлением ИИ её задача лишь усложнилась. Когда она спрашивает руководителей компаний, почему они начали свой бизнес, те перечисляют «три столпа» своей стратегии, говорят о рыночных перспективах и конкурентных преимуществах — всё это звучит безупречно, но слушать совсем не интересно. «Т-Банк» выпустил ИИ-модель распознавания речи с открытым исходным кодом — T-one
22.07.2025 [11:32],
Антон Чивчалов
Российская группа компаний «Т-Технологии», владеющая «Т-Банком», опубликовала собственную ИИ-модель распознавания речи с открытым исходным кодом. Речевая модель под названием T-one обещает новый уровень качества распознавания, по словам её разработчиков. Также обещаются прорывные решения, такие как распознавание речи в реальном времени, передаёт Forbes. 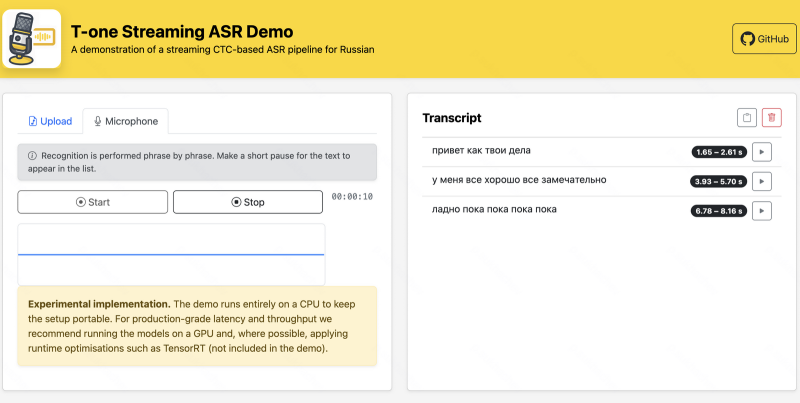
Источник изображения: «Т-Технологии» Более подробно о T-one представители «Т-Технологий» рассказали 19 июля в Москве на Второй конференции по машинному обучению Turbo ML. А на официальном ресурсе компании на платформе GitHub объясняется, что T-one — это высокопроизводительная система автоматического распознавания речи (ASR) с акцентом на распознавание русского языка в телефонии. Кстати, на GitHub она уже доступна для скачивания. Также её можно загрузить с Hugging Face. Для разработчиков приведены инструкции по развёртыванию системы. T-one — модель относительно небольшая, около 70 млн параметров. Для сравнения, речевая модель компании GigaAM от «Сбера» состоит из 240 млн параметров, а модель Whisper large-v3 от OpenAI — из 1,55 млрд. Однако, по утверждениям разработчиков T-One, это не мешает последней обгонять именитых конкурентов именно в распознавании русской речи в телефонных разговорах, под что она «заточена». «Т-Технологии» позиционируют свою разработку как для бизнеса, так и для научного сообщества. Второму она будет интересна низкой стоимостью: эксплуатация на собственном сервере должна быть в десятки раз дешевле конкурирующих решений от облачных провайдеров. T-one хорошо адаптируется под нужды конкретной компании и разработку собственных решений. «Это могут быть компании, разрабатывающие голосовых роботов и ассистентов, занимающиеся автоматизацией кол-центров, — пояснили представители «Т-Технологий» на конференции Turbo ML. — Они могут взять за основу эту модель и адаптировать её под свои решения. Это позволит сократить ресурсы на разработку с нуля». Apple разработала ИИ, выявляющий нетипичные аспекты устной речи — это поможет диагностировать заболевания
06.06.2025 [18:07],
Павел Котов
В рамках проекта, посвящённого голосовым и речевым моделям искусственного интеллекта, Apple опубликовала материалы (PDF) нового исследования, касающегося одной из сложных проблем машинного обучения: распознавание не только того, что было сказано человеком, но и того, как это было сказано. 
Источник изображения: Slavcho Malezan / unsplash.com В статье исследователи описывают схему анализа речи с использованием параметров качества голоса (Voice Quality Dimensions — VQD). Эти параметры указывают на разборчивость, резкость, монотонность речи, придыхание и другие аспекты. На них обращают внимание и логопеды, когда оценивают звучание голоса и влияние на него неврологических состояний и заболеваний. Apple работает над моделями ИИ, также способными их обнаруживать. Большинство речевых моделей обучается на здоровых и типичных для большинства голосах. Если голос человека звучит иначе, ИИ может дать сбой, и это большой недостаток системы, если ей пытается воспользоваться человек с ограниченными возможностями. В работе над этой проблемой исследователи Apple обучили несколько дополнительных моделей ИИ, предназначенных для работы совместно с основными речевыми системами, на большом общедоступном наборе данных аннотированной нетипичной речи, в том числе на голосах людей с болезнью Паркинсона, боковым амиотрофическим склерозом (БАС) и детским церебральным параличом (ДЦП). На этом инженеры компании не остановились — они не стали использовать эти модели для прямой расшифровки сказанного, а составили методику измерения того, как звучит голос, на основе семи основных критериев:
Источник изображения: Iluha Zavaley / unsplash.com Таким образом, ИИ научился «слушать как врач», а не просто регистрировать то, что говорят. Для извлечения звуковых характеристик Apple использовала пять моделей ИИ и обучила дополнительные легковесные алгоритмы, чтобы на основе этих характеристик предсказывать параметры качества голоса. Разработанные компанией дополнительные алгоритмы показали высокие результаты по большинству параметров, хотя качество срабатывания варьировалось в зависимости от конкретного признака и всей задачи. Важнейшим достоинством исследования стало то, что ответы моделей оказались объяснимыми — в отрасли ИИ это встречается нечасто. Вместо того, чтобы показывать условную оценку достоверности (confidence score), система указывает на конкретные характеристики голоса, что упрощает классификацию. Это поможет в клинической оценке и диагностике. Но и на клинической речи в Apple не остановились. Исследователи протестировали свои модели на образцах эмоциональной речи из набора данных RAVDESS: модели VQD не обучались на эмоциональных записях, но также давали прогнозы. Так, в сердитой речи отмечалась низкая «равномерность громкости», а грустные голоса воспринимались как монотонные. Возможно, это поможет улучшить и голосового помощника Apple Siri, который сможет корректировать свои интонации и речь в зависимости от того, как интерпретирует настроение и состояние пользователя, а не только сказанное им. «Голосовое протезирование с ИИ» превратит мозговые волны немых людей в беглую речь
21.04.2025 [18:27],
Сергей Сурабекянц
Немало людей страдают от потери речи в результате заболеваний, хотя их когнитивные функции остаются незатронутыми. Поэтому на волне прогресса в области ИИ многие исследователи сосредоточились на синтезе естественной речи (вокализации) с помощью комбинации мозговых имплантатов и нейросети. В случае успеха эта технология может быть расширена для помощи людям, испытывающим трудности с вокализацией из-за таких состояний, как церебральный паралич или аутизм. 
Источник изображения: unsplash.com Долгое время основные инвестиции и внимание учёных были сосредоточены на имплантах, которые позволяют людям с тяжёлыми формами инвалидности использовать клавиатуру, управлять роботизированными руками или частично восстанавливать использование парализованных конечностей. Одновременно многие исследователи сконцентрировались на разработке технологий вокализации, которые преобразует мыслительные модели в речь. «Мы добиваемся большого прогресса. Сделать передачу голоса от мозга к синтетическому голосу такой же плавной, как диалог между двумя говорящими людьми — наша главная цель, — рассказал нейрохирург из Калифорнийского университета Эдвард Чанг (Edward Chang). — Используемые нами алгоритмы ИИ становятся быстрее, и мы учимся с каждым новым участником наших исследований». В марте 2025 года Чанг с коллегами опубликовали статью в журнале Nature Neuroscience, в которой описали работу с парализованной женщиной, которая не могла говорить в течение 18 лет после перенесённого инсульта. При помощи учёных она обучала нейронную сеть, безмолвно пытаясь произнести предложения, составленные из 1024 разных слов. Затем звук её голоса был синтезирован путём потоковой передачи её нейронных данных в совместную модель синтеза речи и декодирования текста. 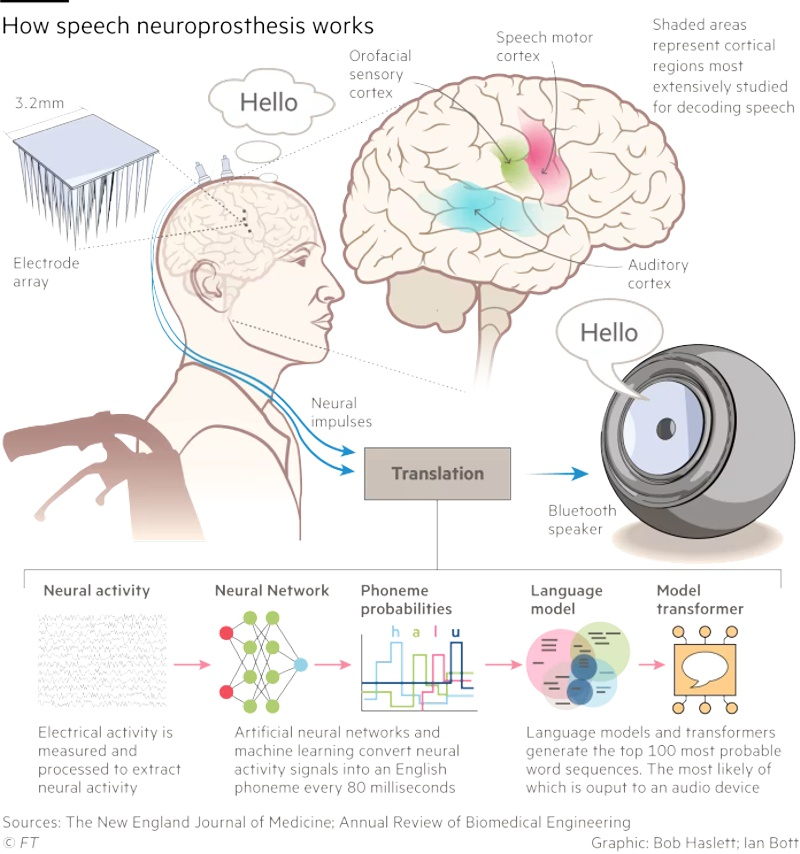
Источник изображения: New England Journal of Medicine Технология позволила сократить задержку между мозговыми сигналами пациента и полученным звуком с первоначальных восьми до одной секунды. Этот результат уже сопоставим с естественным для обычной речи временным интервалом в 100–200 миллисекунд. Медианная скорость декодирования системы достигла 47,5 слов в минуту, что составляет примерно треть от скорости обычного разговора. Аналогичные исследования были произведены компанией Precision Neuroscience, причём её генеральный директор Майкл Магер (Michael Mager) утверждает, что их подход позволяет захватывать мозговые сигналы с более высоким разрешением за счёт «более плотной упаковки электродов». На данный момент Precision Neuroscience провела успешные эксперименты с 31 пациентом и даже получила разрешение регулирующих органов оставлять свои датчики имплантированными на срок до 30 дней. Магер утверждает, что это позволит в течение года обучить нейросеть на «крупнейшим хранилище нейронных данных высокого разрешения, которое существует на планете Земля». Следующим шагом, по словам Магера, будет «миниатюризация компонентов и их помещение в герметичные биосовместимые пакеты, чтобы их можно было навсегда внедрить в тело». 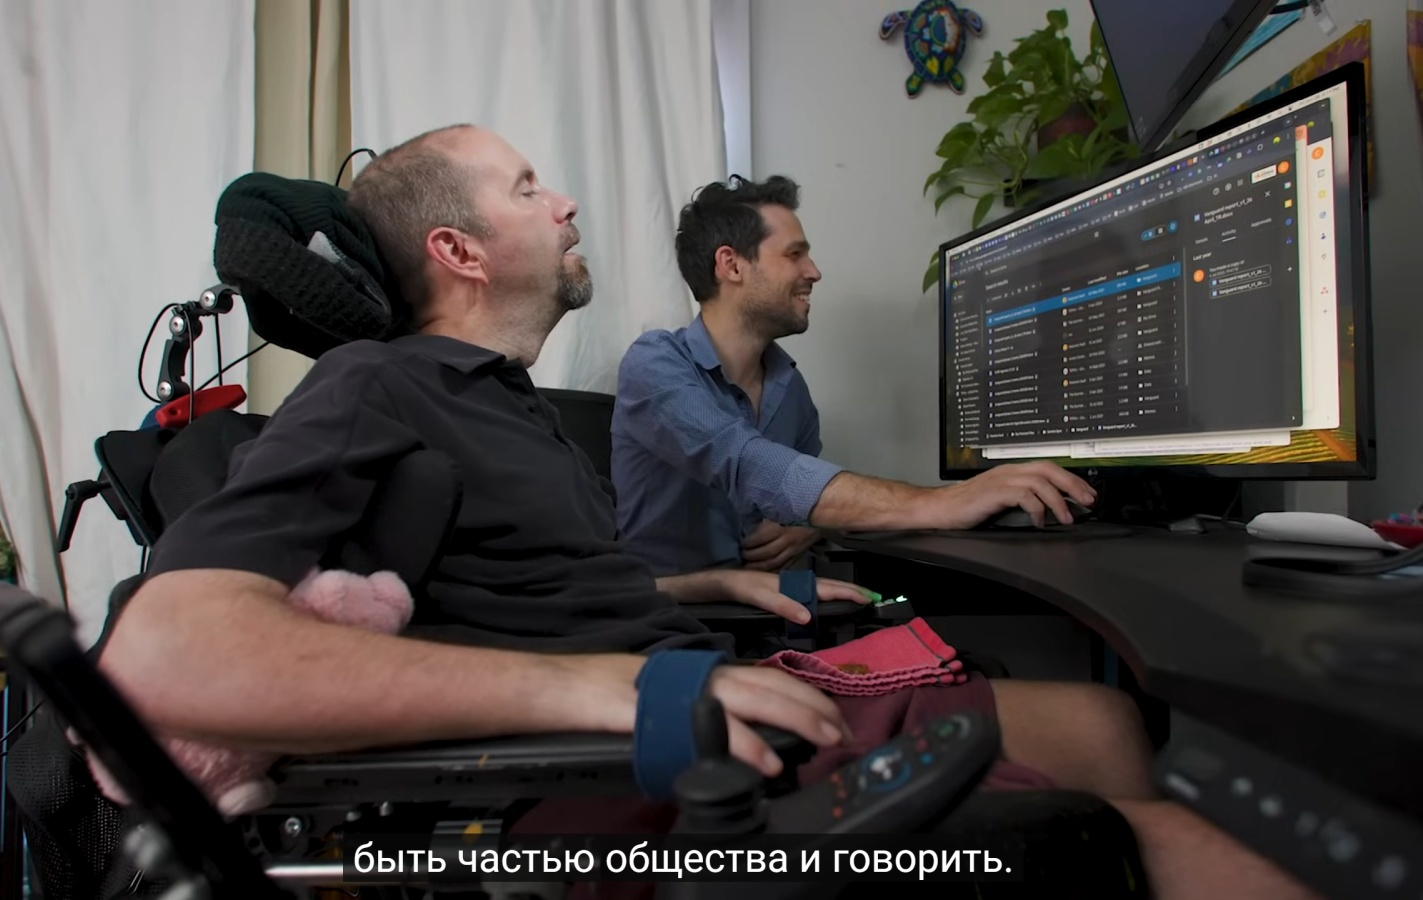
Источник изображения: UC Davis Health Самым серьёзным препятствием для разработки и использования технологии «мозг-голос» является время, которое требуется пациентам, чтобы научиться пользоваться системой. Ключевой нерешённый вопрос заключается в степени различия шаблонов реагирования в двигательной коре — части мозга, которая контролирует произвольные действия, включая речь, — у разных людей. Если они окажутся схожими, предварительно обученные модели можно будет использовать для новых пациентов. Это ускорит процесс индивидуального обучения, который занимает десятки или даже сотни часов. Все исследователи вокализации солидарны в вопросе о недопустимости «расшифровки внутренних мыслей», то есть того, что человек не хочет высказывать. По словам одного из учёных, «есть много вещей, которые я не говорю вслух, потому что они не пойдут мне на пользу или могут навредить другим». На сегодняшний учёные ещё далеки от вокализации, сопоставимой с обычным разговором среднестатистических людей. Хотя точность декодирования удалось довести до 98 %, голосовой вывод происходит не мгновенно и не в состоянии передать такие важные особенности речи, как тон и настроение. Учёные надеются, что в конечном итоге им удастся создать голосовой нейропротез, который обеспечит полный экспрессивный диапазон человеческого голоса, чтобы пациенты могли контролировать тон и ритм своей речи и даже петь. Meta✴ в партнёрстве с ЮНЕСКО запускает новую программу сбора данных для улучшения речи и перевода ИИ
07.02.2025 [18:49],
Сергей Сурабекянц
LTPP (Language Technology Partner Program — партнёрская программа по языковым технологиям) — совместная инициатива ЮНЕСКО и Meta✴✴ по поиску авторов, которые могут предоставить более 10 часов записей речи с транскрипциями, большие объёмы письменного текста и наборы переведённых текстов на разных языках. В дальнейшем эти данные будут интегрированы в ИИ-модели с открытым исходным кодом для распознавания речи и перевода. Усилия LTPP будут сосредоточены на недостаточно обслуживаемых языках для поддержки работы, уже проводимой в этом направлении ЮНЕСКО. «В конечном итоге наша цель — создать интеллектуальные системы, которые могут понимать и реагировать на сложные потребности человека, независимо от языка или культурного происхождения», — заявил представитель Meta✴✴. В дополнение к новой инициативе Meta✴✴ опубликовала открытый исходный код программы для оценки производительности моделей языкового перевода. Тест, состоящий из предложений, созданных лингвистами, поддерживает семь языков, и доступен на платформе разработки ИИ Hugging Face. Meta✴✴ продолжает расширять количество языков, поддерживаемых её ИИ-моделями и развивать функции автоматического перевода для создателей контента. В сентябре прошлого года компания начала тестирование инструмента для перевода голосов в Instagram✴✴ Reels, который дублирует речь создателя на другом языке с автоматическим липсинком. На сегодняшний день обработка на платформах Meta✴✴ контента на языках, отличных от английского, далека от совершенства. По некоторым данным, в соцсети Facebook✴✴ 79 % дезинформации о COVID на итальянском и испанском языках не были распознаны и отмечены системой, по сравнению с 29 % на английском языке. А сообщения на арабском языке, наоборот, часто ошибочно помечаются как разжигающие ненависть. Meta✴✴ заявила, что принимает меры по улучшению своих технологий перевода и модерации. И, хотя компания позиционирует обе свои языковые инициативы как филантропические, нет никаких сомнений, что главным бенефициаром этих программ станет именно Meta✴✴, которая сможет существенно улучшить качество распознавания речи и перевода. |
|
✴ Входит в перечень общественных объединений и религиозных организаций, в отношении которых судом принято вступившее в законную силу решение о ликвидации или запрете деятельности по основаниям, предусмотренным Федеральным законом от 25.07.2002 № 114-ФЗ «О противодействии экстремистской деятельности»; |
© 1997—2026 3DNews
При цитировании документа ссылка на сайт с указанием автора обязательна. Полное заимствование документа является
нарушением
российского и международного законодательства и возможно только с согласия редакции 3DNews.



 MWC 2018
 2018
 Computex

 IFA 2018