



 MWC 2018
 2018
 Computex

 IFA 2018



Исследователи доказали появление нового вида цифрового неравенства. Если двадцать лет назад под этим понимали ограничение доступа к интернету, то с появлением ИИ выяснилось, что стоимость обработки запросов в разы отличается для наиболее и менее распространённых языков. Это ограничивает носителей редких языков и делает их уязвимее.









Источник изображения: ИИ-генерация ChatGPT/3DNews
Исследователи рассматривают разницу в стоимости токенизации для распространённых и малораспространённых языков как скрытое неравенство: обработка одного и того же по смыслу текста на разных языках требует существенно различающегося количества токенов. Об этой проблеме сообщила Коалиция за языковое равенство в исследованиях ИИ (CLEAR). Авторы назвали её «налогом токенизатора» (tokenizer tax).
Токены — это фрагменты текста, аудио- или видеозаписи, на которые специальный алгоритм — токенизатор — разбивает входные данные перед обработкой языковой моделью. Поскольку многие коммерческие ИИ-сервисы рассчитывают стоимость использования моделей по количеству токенов, разбиение текста на большее их количество увеличивает расходы пользователей, работающих на языках, отличных от английского.
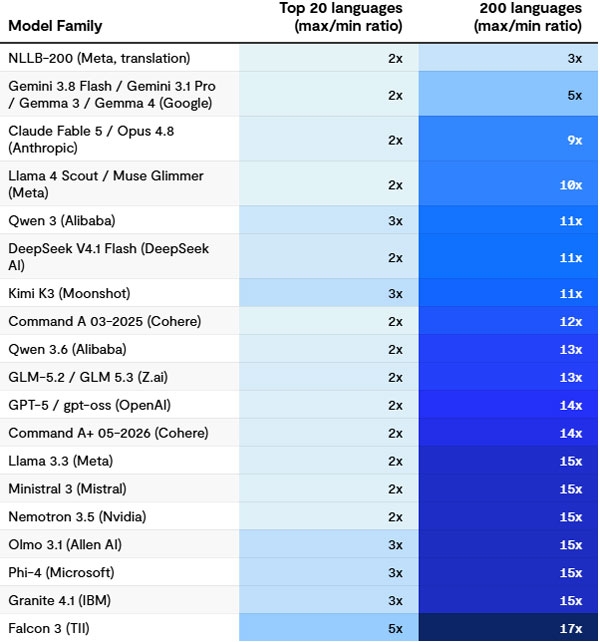
Исследователи сравнили обработку запросов на разных языках, используя корпус текстов FLORES-200, содержащий параллельные переводы предложений примерно на 200 языков. Согласно опубликованным результатам, среди 20 наиболее распространённых в интернете языков разница в количестве токенов между наиболее и наименее ресурсоёмкими вариантами запросов составляла от 1,5 до 5 раз в зависимости от модели.
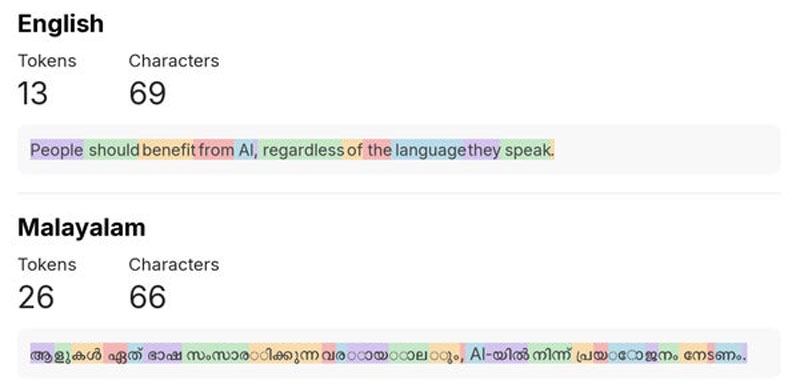
При расширении выборки до 200 языков разрыв для отдельных моделей достигал 17 раз. Например, текст на малаялам (одном из языков южной Индии) может разбиваться на большее количество фрагментов, чем эквивалентный английский текст. В приведённом ниже примере одна и та же фраза на английском и малаялам требует соответственно 13 и 26 токенов. При этом важно понимать, что строгого соотношения стоимости обработки запросов на разных языках нет: всё зависит от текста и контекста, хотя английский язык, очевидно, в большинстве случаев будет иметь преимущество.
Ещё одно ограничение, помимо разницы в стоимости обработки запросов, связано с сокращением доступного объёма контекста. Это может быть даже важнее, поскольку прослеживается чёткая тенденция к снижению стоимости токенов. При одинаковом лимите токенов для контекста более ресурсоёмкий язык оставляет меньше места для документов, предыдущих сообщений, истории взаимодействия и других данных.
Наконец, дополнительные токены могут увеличивать вычислительную нагрузку и задержку ответа. Особенно заметные проблемы выявлены для языков, использующих письменности, недостаточно представленные в обучающих данных токенизаторов. Среди них исследователи выделяют бирманский, тибетский, кхмерский и лаосский языки, а также языки, использующие письменности тифинаг и ол-чики. При этом редкость языка сама по себе не определяет результат: астурийский, например, может получать преимущество благодаря латинскому алфавиту и сходству с другими романскими языками.
В качестве возможных способов уменьшения разрыва специалисты предлагают расширить представление качественных многоязычных данных в обучающих выборках и целенаправленно разрабатывать токенизаторы для разных письменностей. Однако увеличение объёма данных само по себе не гарантирует устранения проблемы: алгоритмы разбиения текста также необходимо совершенствовать. Важно помнить, что само собой ничего не происходит, и разработчики ИИ-моделей должны проникнуться идеей сокращения цифрового неравенства в сфере искусственного интеллекта.
Источник:


