Anthropic анонсировала языковую модель Claude Opus 5.5 — первую в новом семействе Claude 5.5. Компания называет её своим новым флагманом: модель должна заметно превосходить Claude Opus 5 в агентном программировании, работе с компьютером и прикладных офисных задачах, при этом её использование, по данным компании, обходится в среднем на 40 % дешевле.
Источник изображений: Anthropic
Одним из основных направлений развития Opus 5.5 стала работа со сложными и продолжительными задачами, в которых модель должна самостоятельно планировать работу, использовать инструменты, проверять промежуточные результаты и вносить изменения в большой проект.
По данным разработчика, один из ранних пользователей с помощью Claude Opus 5.5 выполнил миграцию кодовой базы объёмом 680 тыс. строк менее чем за сутки — вручную такая задача, по его оценке, заняла бы у команды инженеров несколько недель. В другом тесте модель провела аудит и исправление кодовой базы на 200 000 строк менее чем за три часа; предыдущей версии Claude Opus 5 на аналогичную работу потребовалось более 20 часов и в 2,5 раза больше токенов.
В тесте по миграции HAProxy с языка C на Rust модель Opus 5.5 завершила работу за 9,5 часа против 12 часов у Fable 5.1, и её работа обошлась на 51 % дешевле. Anthropic также отмечает улучшения при оптимизации программного обеспечения: в одном из испытаний Opus 5.5 смогла сократить время загрузки всех страниц веб-приложения в 39 из 40 случаев, тогда как Opus 5 чаще вносила менее значительные изменения и могла при этом менять поведение приложения.
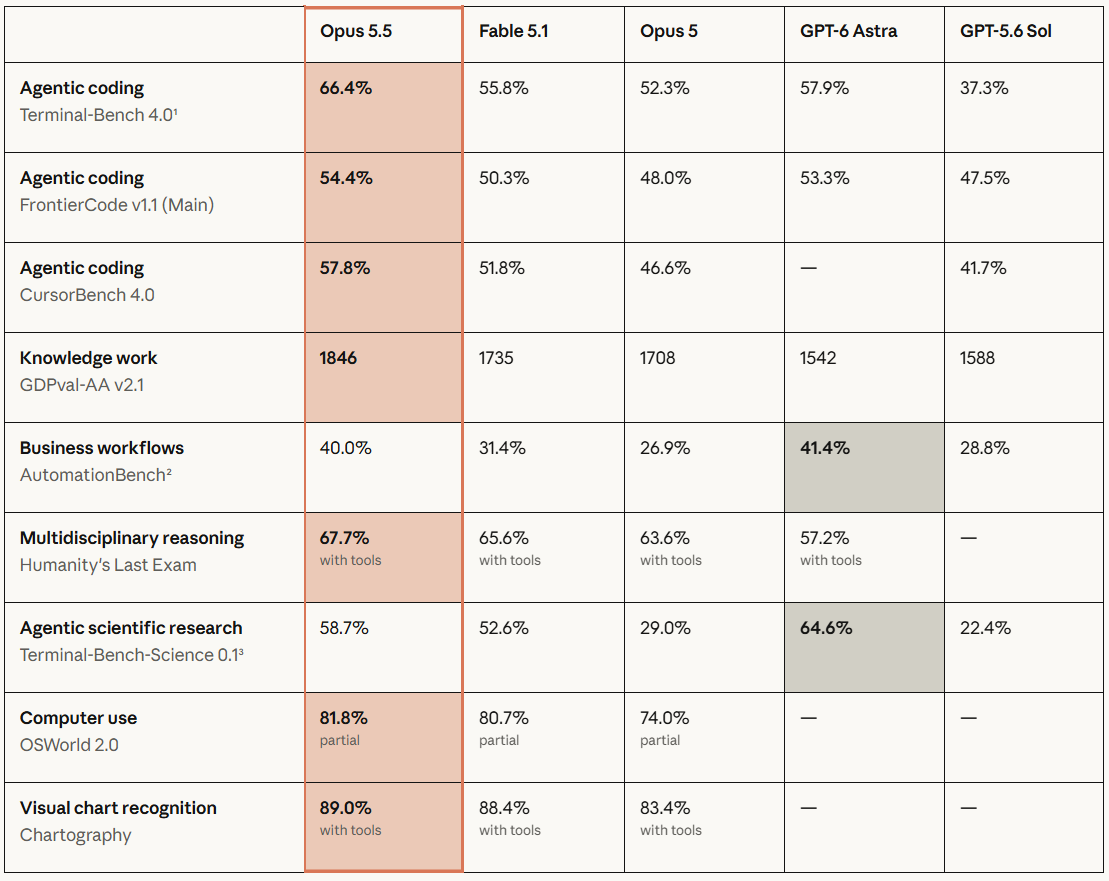
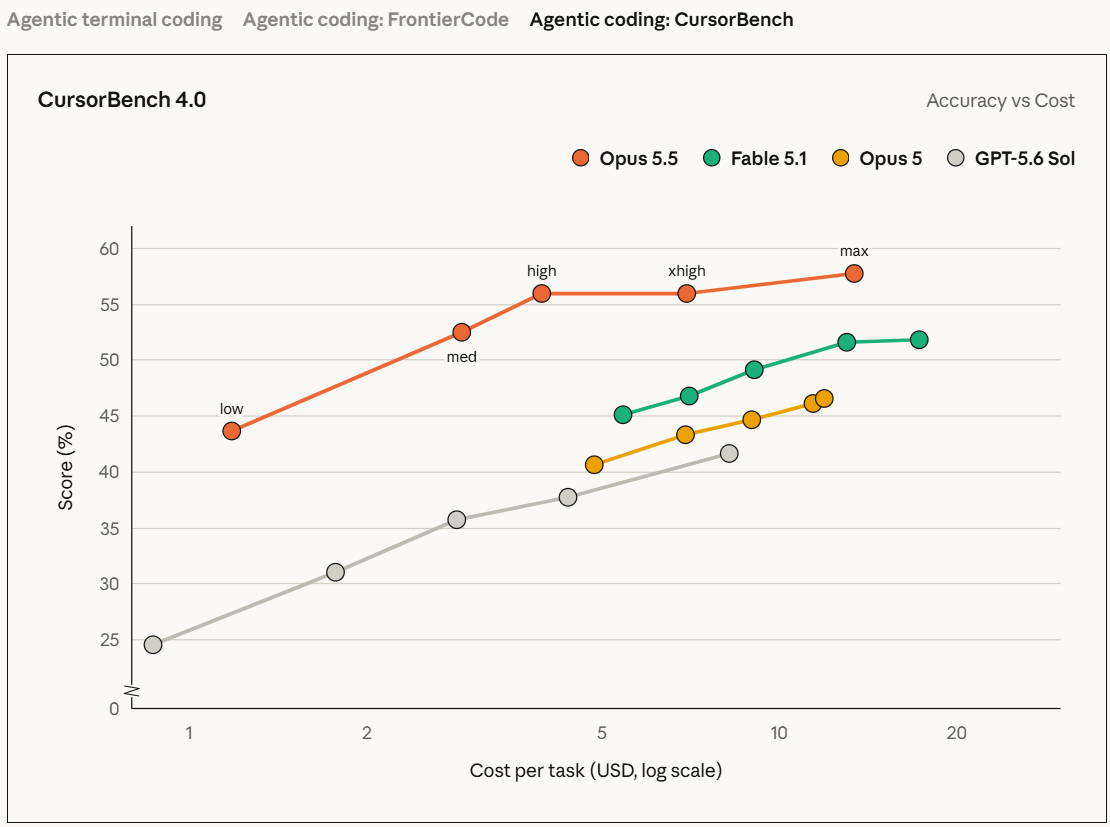
По внутренним тестам Anthropic, в бенчмарке Terminal-Bench 4.0, оценивающем способность ИИ-агентов выполнять многошаговые задачи в командной строке, Claude Opus 5.5 набрала 66,4 %. Это выше результатов Claude Opus 5, Fable 5.1, GPT-6 Astra и GPT-5.6 Sol. Во FrontierCode v1.1 новая модель получила 54,4 %, тогда как Claude Fable 5.1 набрала 50,3 %, а GPT-6 Astra — 53,3 %. В бенчмарке CursorBench 4.0 результат Opus 5.5 составил 57,8 %, что лучше показателей Fable 5.1 и Opus 5.
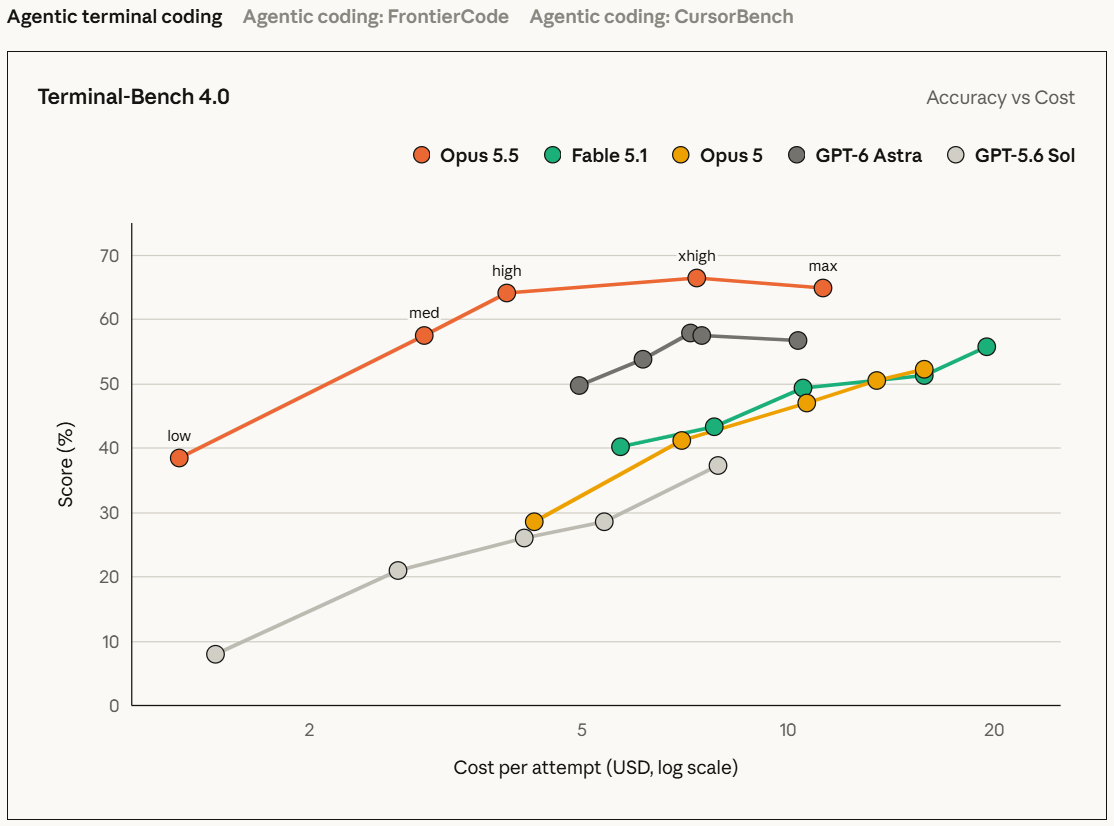
Anthropic отдельно отмечает, что в случае с флагманскими моделями разница в бенчмарках не всегда точно отражает реальные различия между моделями. По её собственной оценке, практический разрыв между Opus 5.5 и Claude Fable 5.1 меньше, чем можно предположить по приведённым результатам испытаний.
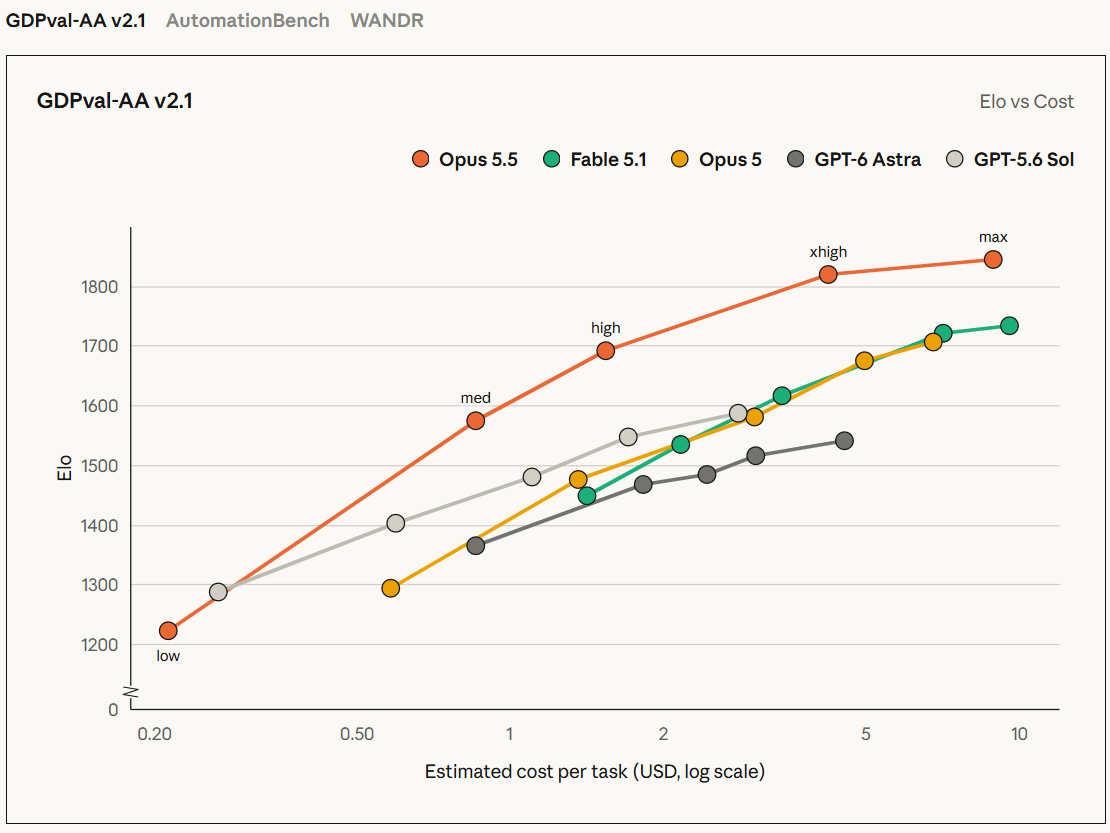
Разработчик также обещает улучшения в работе с текстами, исследованиями, финансовыми моделями и деловыми документами. На тесте GDPval-AA v2.1, который имитирует профессиональные задачи по 44 специальностям, Claude Opus 5.5 получила рейтинг 1846 очков. Для сравнения, у Fable 5.1 этот показатель составил 1735, а у Opus 5 — 1708.
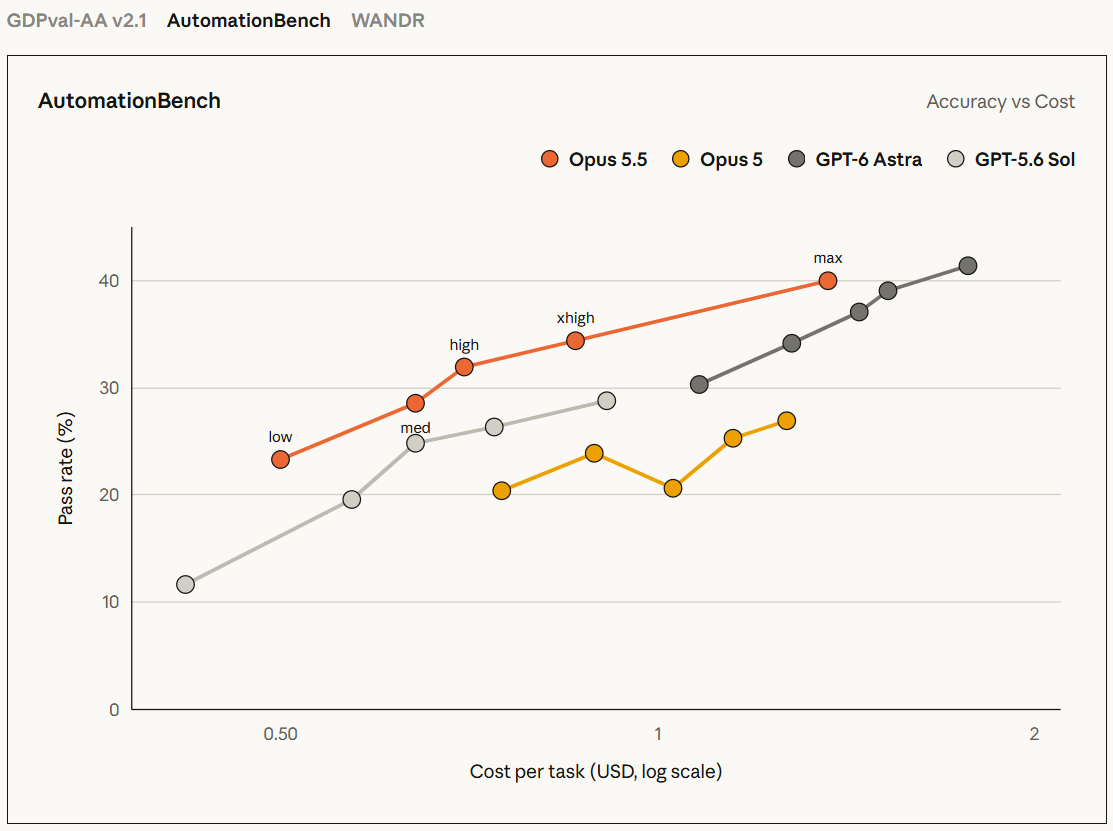
В одном из внутренних тестов модель попросили подготовить отчёт по финансовым результатам компании, используя специально подготовленную копию Сети, где нужный релиз было трудно найти. Opus 5.5 прошла установленный компанией порог качества — когда ошибка в любой цифре или цитате приводила к провалу теста — в 16 из 18 попыток, тогда как Fable 5.1 и Opus 5 не справились ни в одной.
Anthropic отдельно переработала стиль общения модели. Компания утверждает, что Opus 5.5 стала лучше структурировать ответы, сразу выносить ключевую информацию и реже использовать жаргон или необычные формулировки. Это должно сделать модель более удобной для длительной совместной работы с пользователем.
При этом Anthropic отдельно подчёркивает эффективность новой модели. Стоимость миллиона входных токенов снижена с $5 до $4, а выходных — с $25 до $20. Чтение из кэша подешевело с $0,50 до $0,20 за миллион токенов, а запись стоит $5 за 1 млн вместо $6,25. По данным компании, с учётом меньшего количества токенов, необходимого для выполнения задач, общая стоимость использования модели в среднем снижается на 40 %. Скорость генерации также выросла более чем на 30 %. Для Opus 5.5 предусмотрен и ускоренный режим Fast Mode: в Claude Code и Claude Platform он обеспечивает скорость до 2,5 раза выше стандартной, но стоит $8 за миллион входных и $40 за миллион выходных токенов.
Перед выпуском Claude Opus 5.5 прошла внешнее тестирование, в том числе с участием Frontier Design и METR. Anthropic утверждает, что модель лучше предыдущих Claude соблюдает заданные ограничения, а в тестах на попытки выйти за пределы изолированной среды делала это примерно на 85 % реже, чем Opus 5 и Mythos 5.1. При этом компания признаёт, что полностью выявить риски поведения ИИ до развёртывания невозможно.
Для чувствительных запросов в области кибербезопасности, биологии и дистилляции моделей действуют дополнительные меры контроля. Большинство задач по кибербезопасности будет перенаправляться на Claude Opus 4.8, а расширенный доступ к Opus 5.5 смогут получить проверенные специалисты через программы Cyber Verification и Life Sciences Verification.
Также утверждается, что Opus 5.5 лучше противостоит атакам с внедрением инструкций (prompt injection) и реже предпринимает необратимые действия. Кроме того, Anthropic внедрила механизм preserved thinking, призванный затруднить массовое извлечение внутренних рассуждений модели через сеть поддельных API-аккаунтов.
Claude Opus 5.5 уже доступна в чат-боте Claude, через API и другие сервисы Anthropic. В ближайшие недели Anthropic также обещает выпустить Claude Sonnet 5.5 и Claude Haiku 5.5, которые получат многие из тех же улучшений производительности, эффективности и безопасности.