В недавнем вводном материале мы довольно подробно выясняли, по какой причине пользователю, имеющему свободный доступ даже к бесплатным версиям полноценных облачных языковых моделей (БЯМ), не говоря о подписке на платные, может понадобиться развёртывать локальный ИИ — и решать с его помощью какие бы то ни было практические задачи. Прекрасно осознавая, что перечень предложенных нами разновидностей таких задач неполон (хотя и довольно обширен — статья с его рассмотрением получилась объёмистой), мы призываем читателей дополнять его в комментариях и/или письмах в редакцию: вполне вероятно, что какое-то бесспорно полезное и приятное приложение мы и упустили. А пока будем переходить к делу: активируем рабочую среду Unsloth Desktop (или установим её с нуля — благо, это недолго), загрузим одну из наиболее актуальных на сегодня моделей с открытыми весами и посмотрим, на что та годится. Но для начала всё-таки поясним, почему для первой «Мастерской» такого рода остановили свой выбор именно на Qwen3.8, которую китайские товарищи из Alibaba представили в пригодной для запуска на персоналке версии 27B (с 27 млрд рабочих параметров) спустя всего несколько дней после того, как анонсировали в августе 2026 г. свою новую флагманскую большую языковую модель (БЯМ) этого поколения, Qwen3.8-Max с 2,4 трлн параметров.
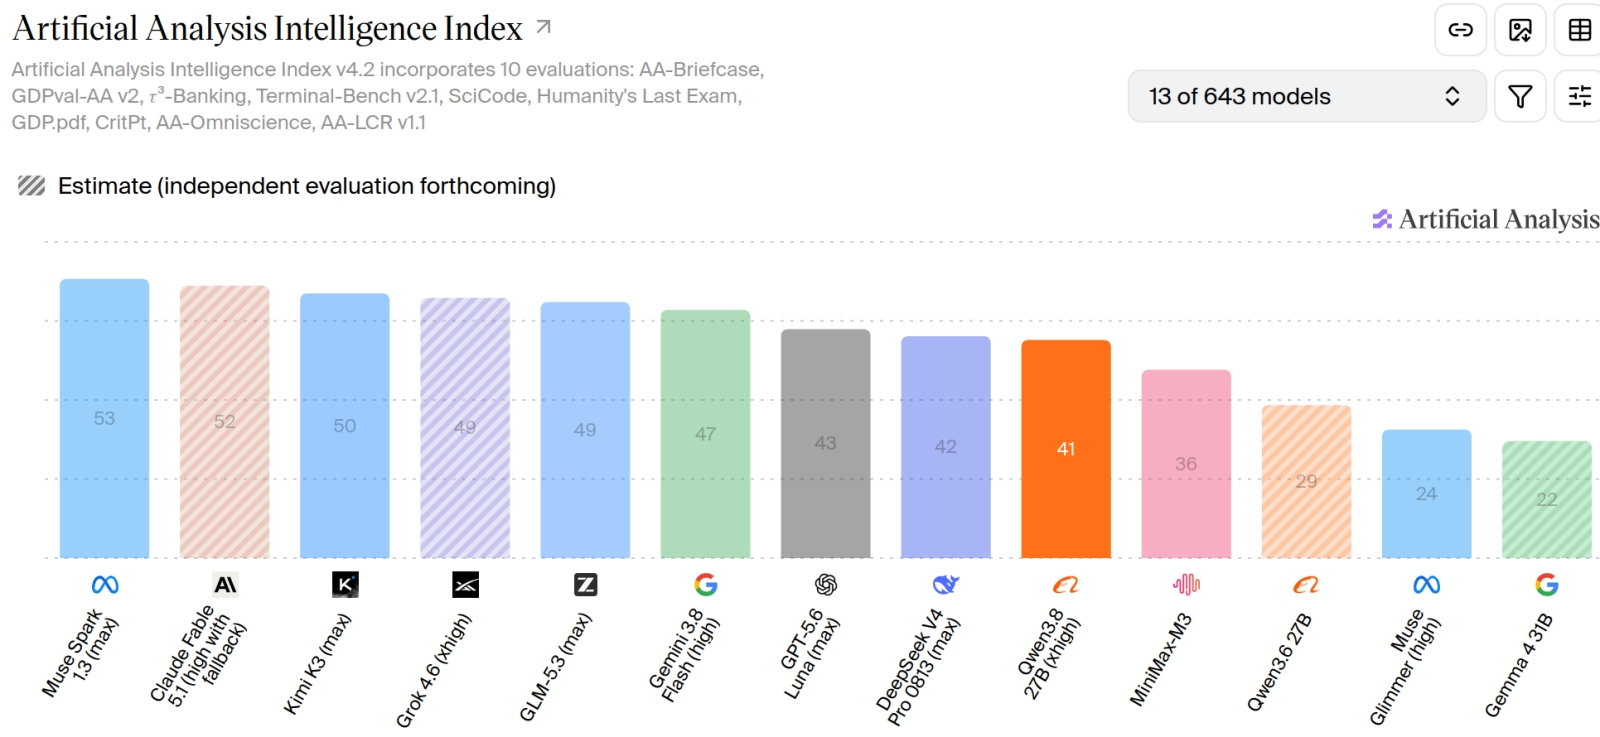
По итогам прохождения независимого бенчмарка Intelligence Index модель Qwen3.8-27B заработала 41 балл — совсем немногим меньше проприетарной GPT-5.6 Luna. Важное замечание: сам бенчмарк регулярно и довольно часто обновляют, так что приведённые здесь абсолютные величины актуальны лишь на момент написания настоящей «Мастерской» — хотя относительные их значения для разных моделей в целом сохраняются (источник: Artificial Analysis)
В материковом Китае латиница не в чести: в текстовых коммуникациях внутри страны иероглификой передаются даже названия западных компаний и личные имена длинноносых варваров, — так уж исторически сложилось. Само собой, локальные разработки — даже выходящие в итоге на международный рынок — именуются тоже на свой, иероглифический лад. Оригинальное название серии БЯМ, разрабатываемой компанией Alibaba Cloud по меньшей мере с 2023 года и известной миру за пределами КНР как Qwen, — 通义千问. В наиболее распространённой версии латинизации китайского языка, пиньинь, оно передаётся как «tongyi qianwen»; в русскоязычной транскрипции по системе Палладия — «тунъи цяньвэнь» (твёрдый знак перед «и» необходим, чтобы не смягчать машинально при чтении «н»). Перевести же эту истинно по-китайски цветистую фразу можно как «поиск истины через тысячу вопрошаний». Вот финальный иероглиф 问 («wen», «вэнь») со значением «спрашивать» как раз и сделался окончанием латинизированного имени этой БЯМ, — Qwen. А стоящая в начале литера Q у любого англоговорящего (благо, это одна из реже всего используемых букв в языке Шекспира и Байрона, так что вариантов немного) вызывает стойкую ассоциацию со словом question, — «вопрос». «Задавайте ваши вопросы», в общем; неплохой каламбур. Ну что ж, будем задавать — только сперва уточним, чему именно.
Семейство моделей Qwen3.8 было явлено миру в августе 2026 года; это довольно широкий спектр БЯМ, способных вести рассуждения, создавать программный код, работать с различными представлениями данных (текст, звук, изображения) и действовать в агентном режиме. Исходно мы ориентировались прежде всего на вариант Qwen3.8-27B с 27 млрд рабочих параметров и предельным контекстным окном на 256 Кбайт, формально пригодный для запуска на нашей тестовой картофелине (Core i7-2700K, 24 Гбайт DDR3-1333, GeForce GTX 1070 с 8 Гбайт VRAM). Правда, в исходной версии, когда каждый параметр записывается как 16-разрядная десятичная дробь, версия 27B целиком не поместится в видеопамять никакого одиночного графического адаптера потребительского класса — даже с 32 Гбайт. К счастью, рабочая среда Unsloth Desktop изначально ориентирована на запуск моделей в представлении GGUF и существенно более экономичных квантизациях, так что подходящего размера файл, пусть и частично ограниченный по возможностям в сравнении с оригиналом, отыскать мы сумеем. Помимо 27B, в рассматриваемое семейство входят Qwen3.8-Flash-Next («разреженный» ансамбль экспертов — sparse MoE — со 180 млрд параметров всего и лишь 6 млрд активных; похоже, кстати, именно в направлении sparse MoE пойдёт развитие следующего поколения, Qwen4), Qwen3.8-2.4T-A95B (более плотный MoE: 2,4 трлн параметров всего, 95 млрд активных), а также флагманская Qwen3.8-Max с закрытыми, в отличие ото всех прочих, весами (тоже 2,4 трлн параметров), ориентированная на профессиональное применение, включая многоэтапную агентную активность с долгосрочным планированием при минимальном вмешательстве оператора.
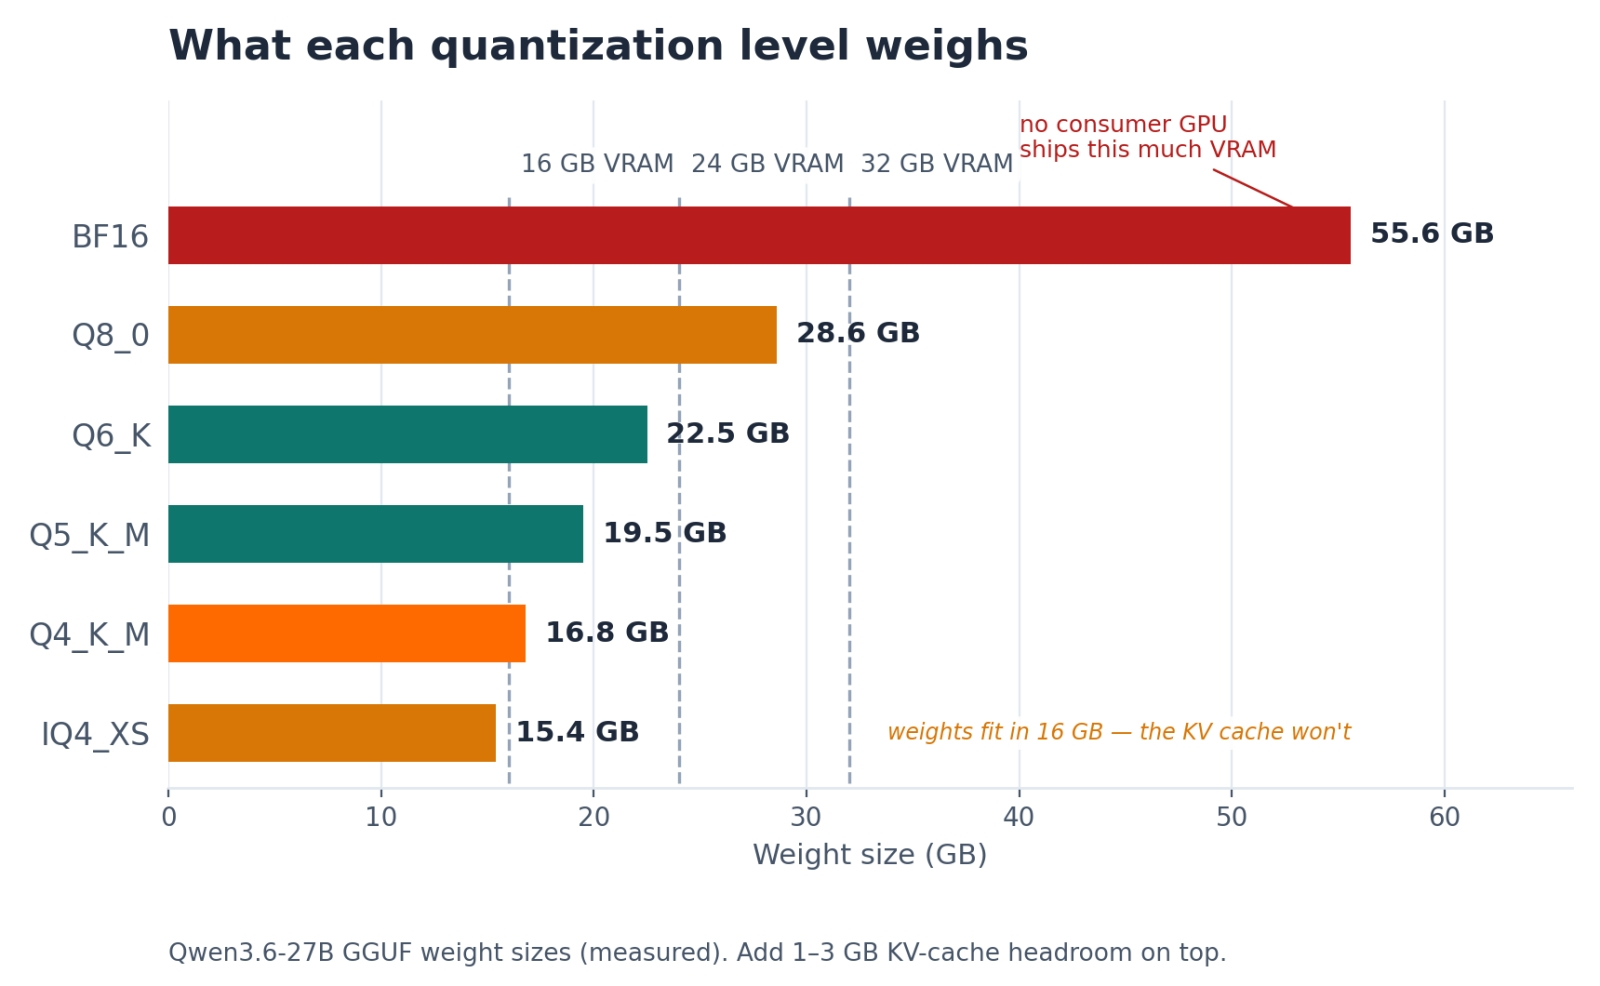
Сравнение объёмов файлов модели Qwen3.8-27B для различных вариантов квантизации (источник: Alibaba Cloud)
Отдельные восторженные эксперты провозглашали августовский анонс Qwen3.8-27B то «DeepSeek-моментом для ИИ с открытыми весами», то «самыми революционными из когда-либо опубликованных двадцатью гигабайтами данных» (файл этой модели в широко применяемой 4-разрядной квантизации занимает как раз менее 20 Гбайт). Эмоционально, спору нет, но не так уж безосновательно: эта модель с распространяемыми по лицензии Apache 2.0 весами умещается целиком (вместе с кэшем токенов, которыми оперирует в ходе обработки каждого запроса) в видеопамять геймерского графического адаптера с 24 Гбайт VRAM вроде RTX 3090 или 4090 — или же в унифицированное ОЗУ не самого мощного Apple Mac с достаточно современным ARM-процессором. Контекстное окно этой мультимодальной модели простирается на 262 144 токена, что приближённо соответствует 1 млн типографских знаков или 170−200 тыс. слов англоязычного текста. В ходе независимых испытаний Artificial Analysis комплексный показатель Intelligence Index (оценка способностей нейросети в общих познаниях, логических рассуждениях, математике и программировании) для Qwen3.8-27B, исполняемой в режиме рассуждений xhigh, составил 41 балл. Чуть выше, для сравнения, были оценены доступная только через облако GPT-5.6 Luna и существенно более крупная по числу параметров открытая MoE-модель DeepSeek V4 Pro. По сравнению с прямой предшественницей, Qwen3.6-27B, прогресс тоже есть, и весьма ощутимый: последняя (в версии reasoning) на том же бенчмарке набрала лишь 29 баллов.
Оговоримся, впрочем, что все подобного рода сравнительные испытания обычно проводят на как можно менее стеснённых в аппаратном смысле платформах — чтобы на результаты не влияло исчерпание физического объёма доступной видеопамяти. Локальная же производительность на имеющемся в распоряжении данного конкретного энтузиаста «железе» (вроде нашей картофелины) зависит от выбираемых как на этапе загрузки модели, так и в ходе настройки рабочей среды параметров: типа и глубины квантизации, размеров контекстного окна и проч. По умолчанию для исполняемых на ПК моделей чаще всего предлагаются такие настройки, которые обеспечивают наилучшее качество ответов на пользовательские запросы — что, вообще говоря, логично: иначе зачем огород-то городить? Но «логическое мышление» Qwen3.8-27B настолько глубоко, что порой для ответа не самый каверзный вопрос модель тратит многие сотни, если не тысячи, токенов — неустанно перепроверяя себя, запуская промежуточные тесты (если задано создание кода) и сверяясь с внешними источниками данных (опять-таки, если ей разрешили доступ в Сеть). С учётом ограниченности контекстного окна на персоналке, особенно оснащённой видавшей виды 8-Гбайт видеокартой, такое поведение неизбежно ведёт к дополнительным затратам времени на каждый ответ и снижению производительности — когда это самое окно «выплёскивается» из сравнительно быстрой VRAM в системную RAM. Здесь, конечно, каждому следует самому определиться, что важнее — скорость или корректность ответа. В любом случае, понимать, какие параметры и как определяют работу локальной модели, необходимо.
В ходе очередного запуска Unsloth Desktop предложила обновить и себя, и llama.cpp
Итак, приступим: если на вашем компьютере с прошлого раза не установлена рабочая среда для исполнения локальных языковых моделей (кстати, в ней ещё и LoRA можно обучать — но этим мы пока заниматься не станем) Unsloth Desktop (здесь и далее — UD), проинсталлировать её вовсе не трудно. Попутно заметим, что сразу после очередного запуска эта среда первым делом проверяет наличие обновлений — как для себя самой, так и для главного инструмента, который, собственно, и обеспечивает исполнение нейросетей (представленных в компактном формате GGUF, в частности) в памяти персоналки — инференс-движка с открытым кодом llama.cpp. Завзятые поклонники командной строки вольны пользоваться этим движком напрямую, но мы всё-таки предпочтём удобство и дополнительные возможности интерфейса UD: для начинающих эта среда — одна из наиболее удобных в обращении и детально документированных.
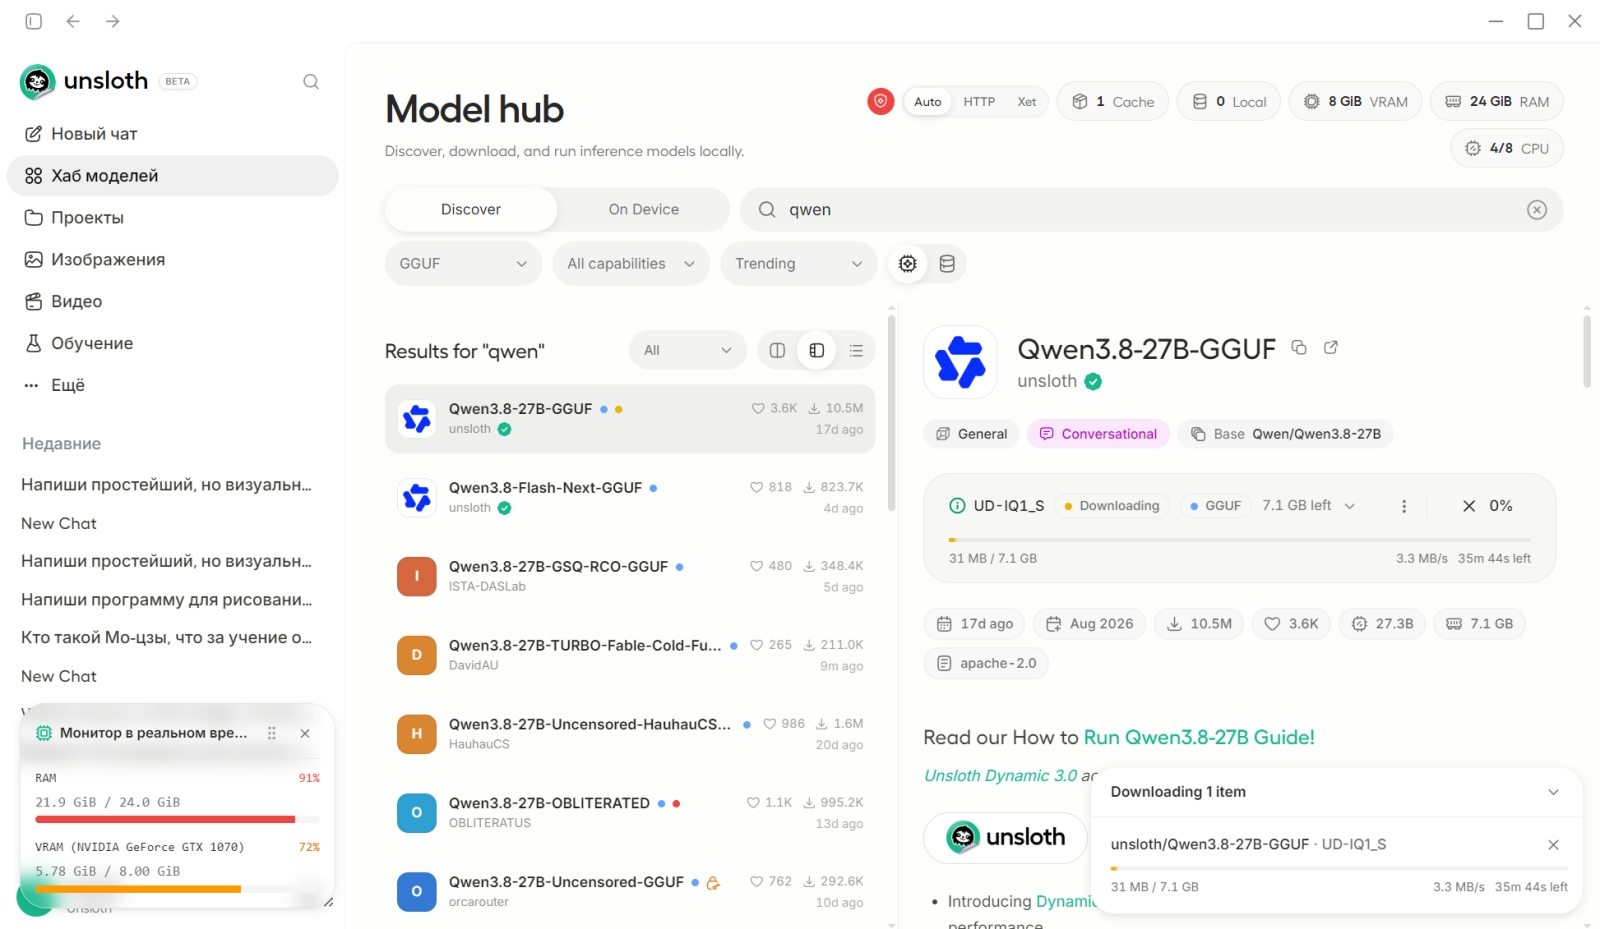
В левом верхнем углу интерфейсного окна UD видна квадратная иконка с вертикальной чертой: щелчок по ней откроет с левой стороны меню с целым рядом опций и ссылками на сохранённые протоколы прежних сессий. Клик по строке «Хаб моделей» предоставит доступ к разделу «Model hub» (да, язык меню по умолчанию выбирается в соответствии с системным, а язык отображения самих разделов — нет; бета-версия, как-никак!), и там, в строке поиска, мы зададим первые литеры названия того, что ищем; в данном случае — «qwen». В числе первых должна появиться ссылка на оригинальную модель Qwen3.8-27B — её легко отождествить как по фирменному логотипу, так и по числу произведённых через UD загрузок (на момент написания настоящей статьи — 10,5 млн).
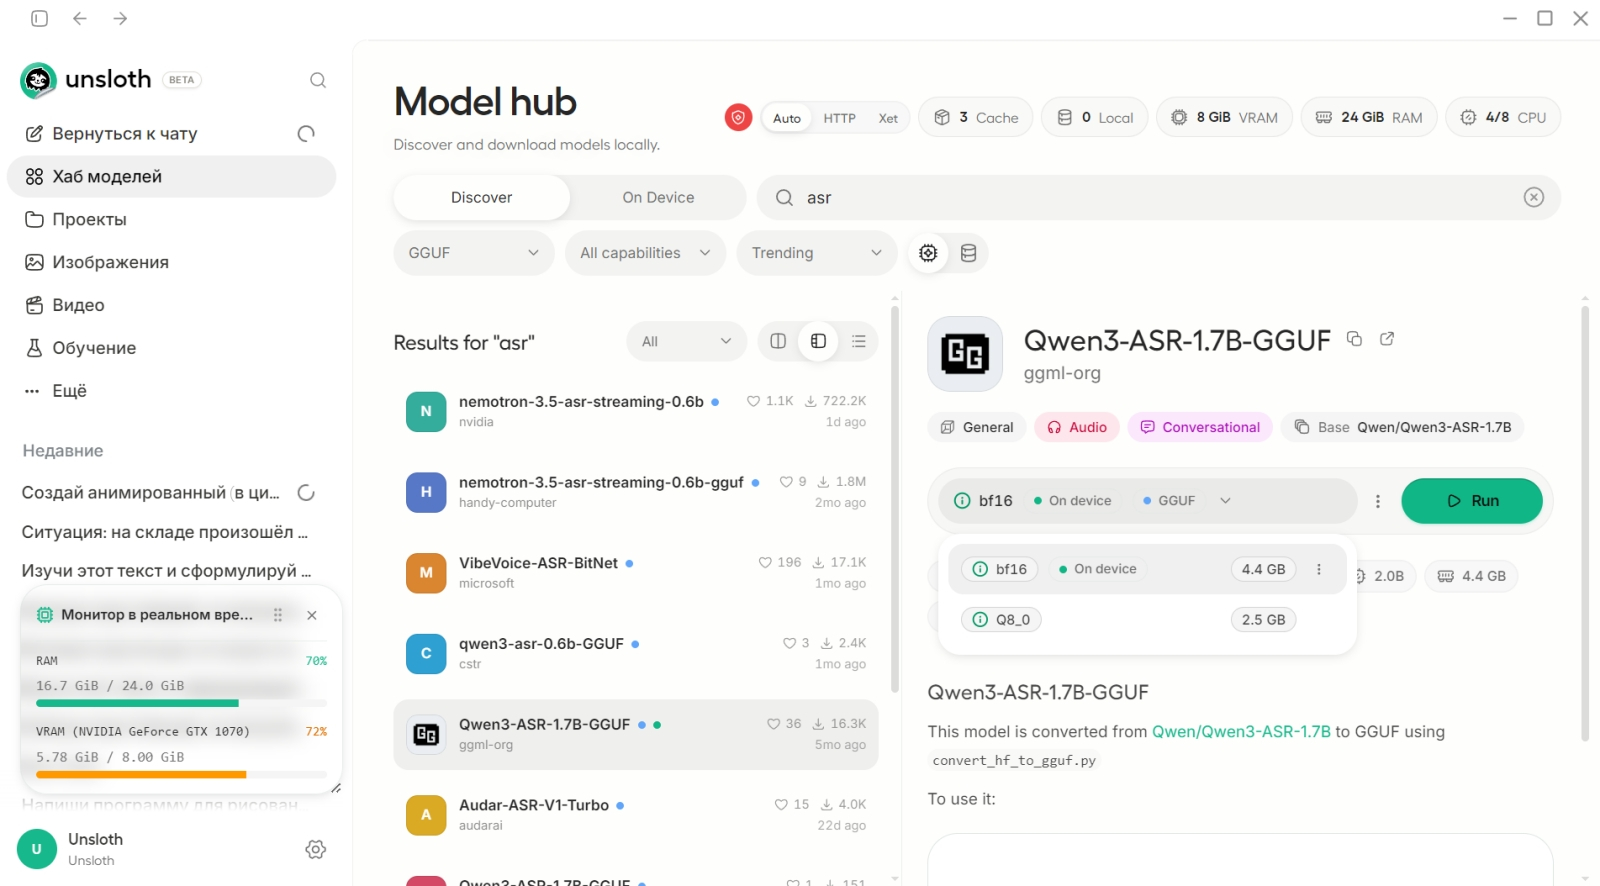
Даже для такой небольшой модели, как специализированная на преобразовании аудиозаписей в текст Qwen3-ASR-1.7B, в UD предусмотрены два варианта квантизации
По умолчанию UD предлагает пользователю, предварительно оценив доступные в его системе объёмы VRAM и RAM, наиболее подходящий «сжатый» вариант выбранной модели; в данном случае — UD-IQ3_S. Это особый динамический формат квантизации, разработанный в рамках проекта тензорной библиотеки GGML (за которым стоит Георгий Греганов, Georgi Gerganov, оригинальный создатель того самого llama.cpp) и активно популяризируемый именно специалистами Unsloth. Вот почему, в частности, мы и отдали в актуальной серии «Мастерских» предпочтение именно этой рабочей среде: квантизация IQ как часть стандарта GGUF 3.0 опирается на калибровку матрицы важности (importance-matrix — imatrix) для выборочного повышения точности наиболее важных слоёв модели при одновременном сжатии остальных. В результате, как отмечают уже многие энтузиасты, модель сохраняет все возможности вызова инструментов и генерирует ответы практически без снижения их качества по сравнению с выдачей версии в более тяжеловесной квантизации вроде Q8_0 — занимая притом заметно меньший объём памяти и производя инференс быстрее.
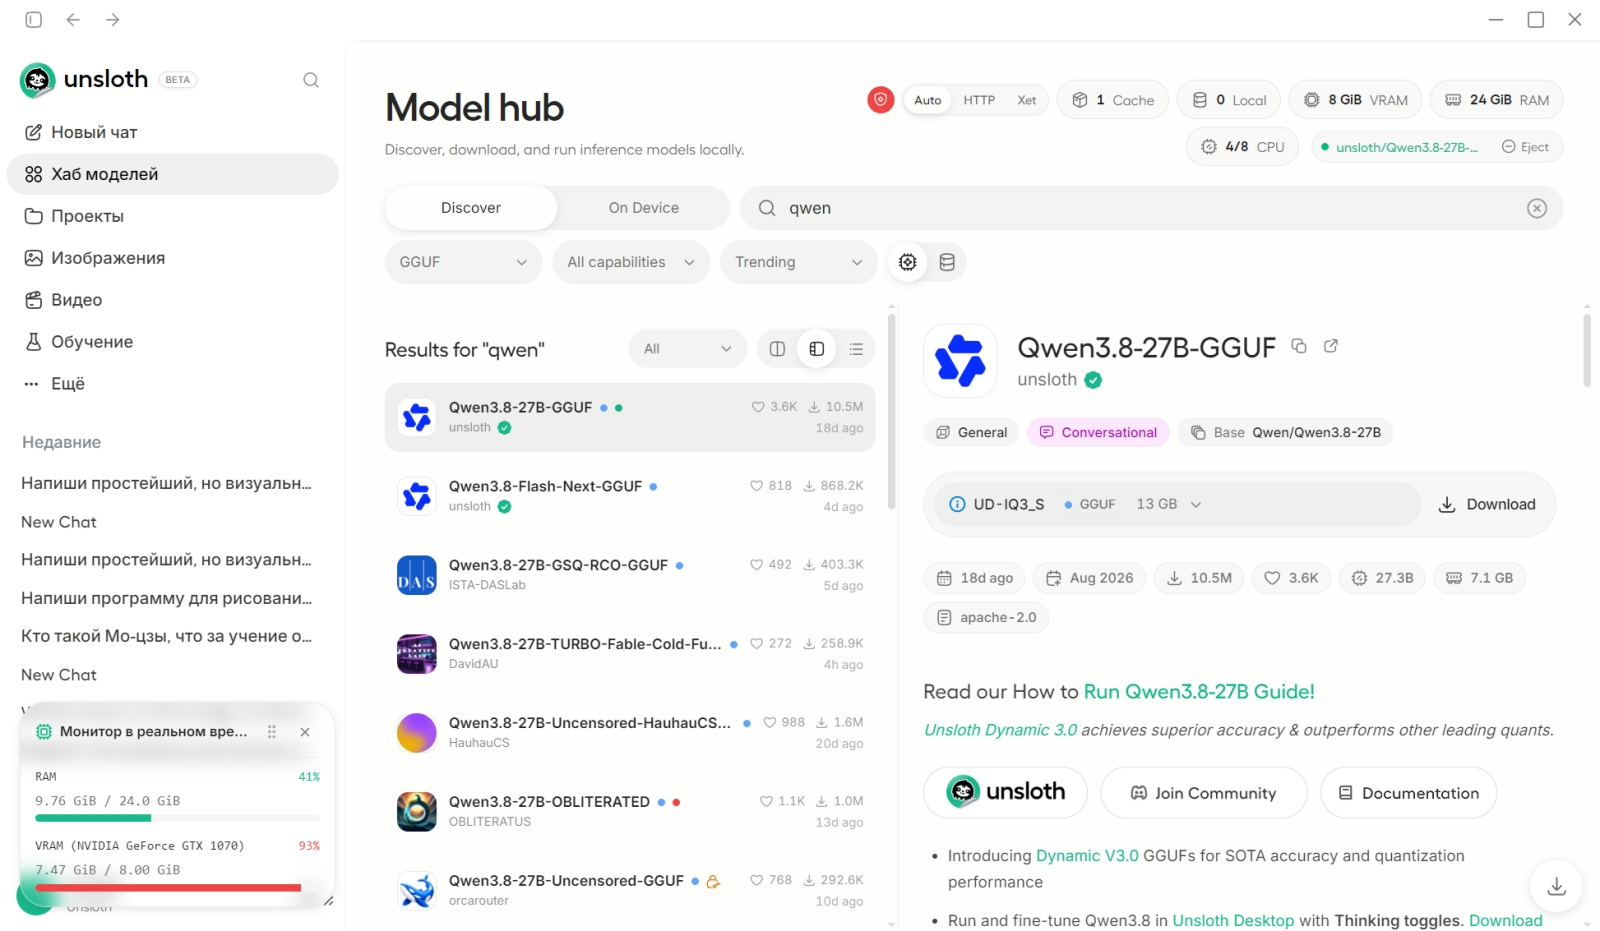
Увы, даже в квантизации UD-IQ3_S файл модели Qwen3.8-27B тянет на 13 Гбайт. Нет-нет, он загрузится как следует и формально заработает — вот только скорость инференса выйдет чрезмерно низкой, 0,2−0,4 токена в секунду; мы несколько позже приведём пару наглядных примеров. По этой причине есть смысл открыть выпадающее меню рядом с наименованием предложенной модели и выбрать ещё более сжатый вариант в формате UD-IQ1_S, объём файла которого — 7,1 Гбайт. Так в видеопамяти останется достаточно места для самой операционной системы и некоторых вспомогательных программ (веб-браузера, например); правда, контекстное окно выйдет слишком уж незначительным — придётся его чуть позже расширить.
Отдаём команду на загрузку файла модели (скорость её зависит от качества соединения с интернетом), и когда закачка завершится, справа в той же строке появится большая зелёная кнопка с надписью «Run». Нажимаем её — и поехали!
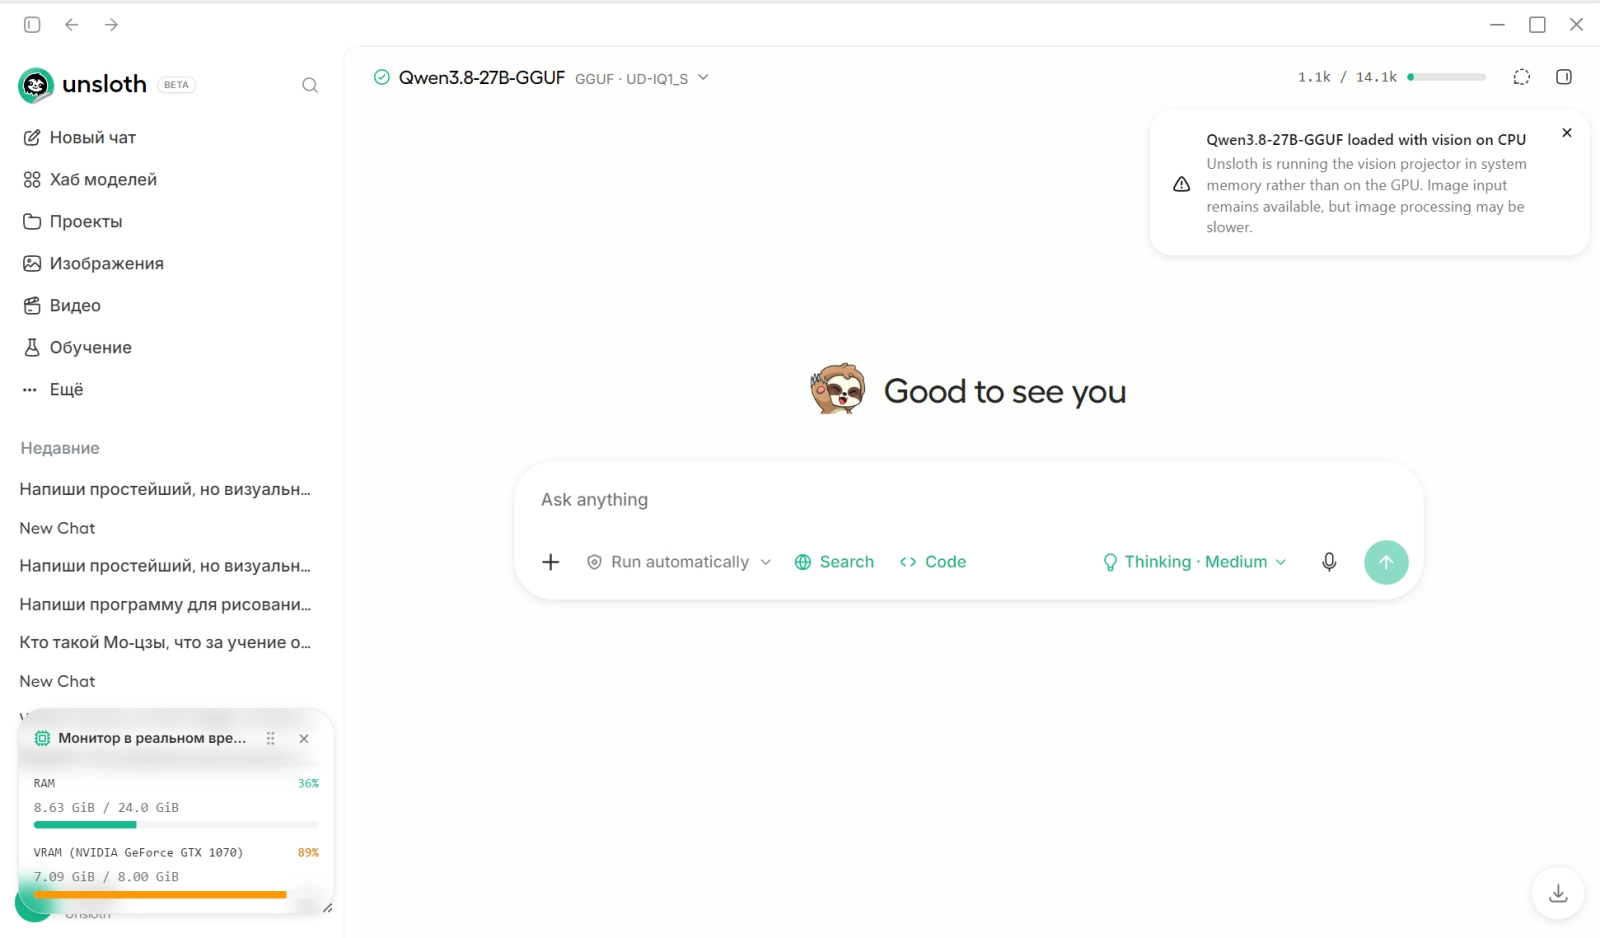
В правом верхнем углу — информация о доступном контекстном окне после загрузки: 1,1 тыс. токенов уже задействовано на этапе инициализации модели, 14,1 тыс. может быть использовано всего. Также UD сообщает, что блок обработки визуальных данных из-за нехватки видеопамяти вынесен в RAM, и потому отвечать на запросы с входными данными в виде картинок система будет медленнее
Прежде всего заглянем в настройки параметров исполняемой модели: другая иконка в виде квадрата с вертикальной чертой, уже в правом верхнем углу; при наведении на неё всплывает подсказка «Open run settings».
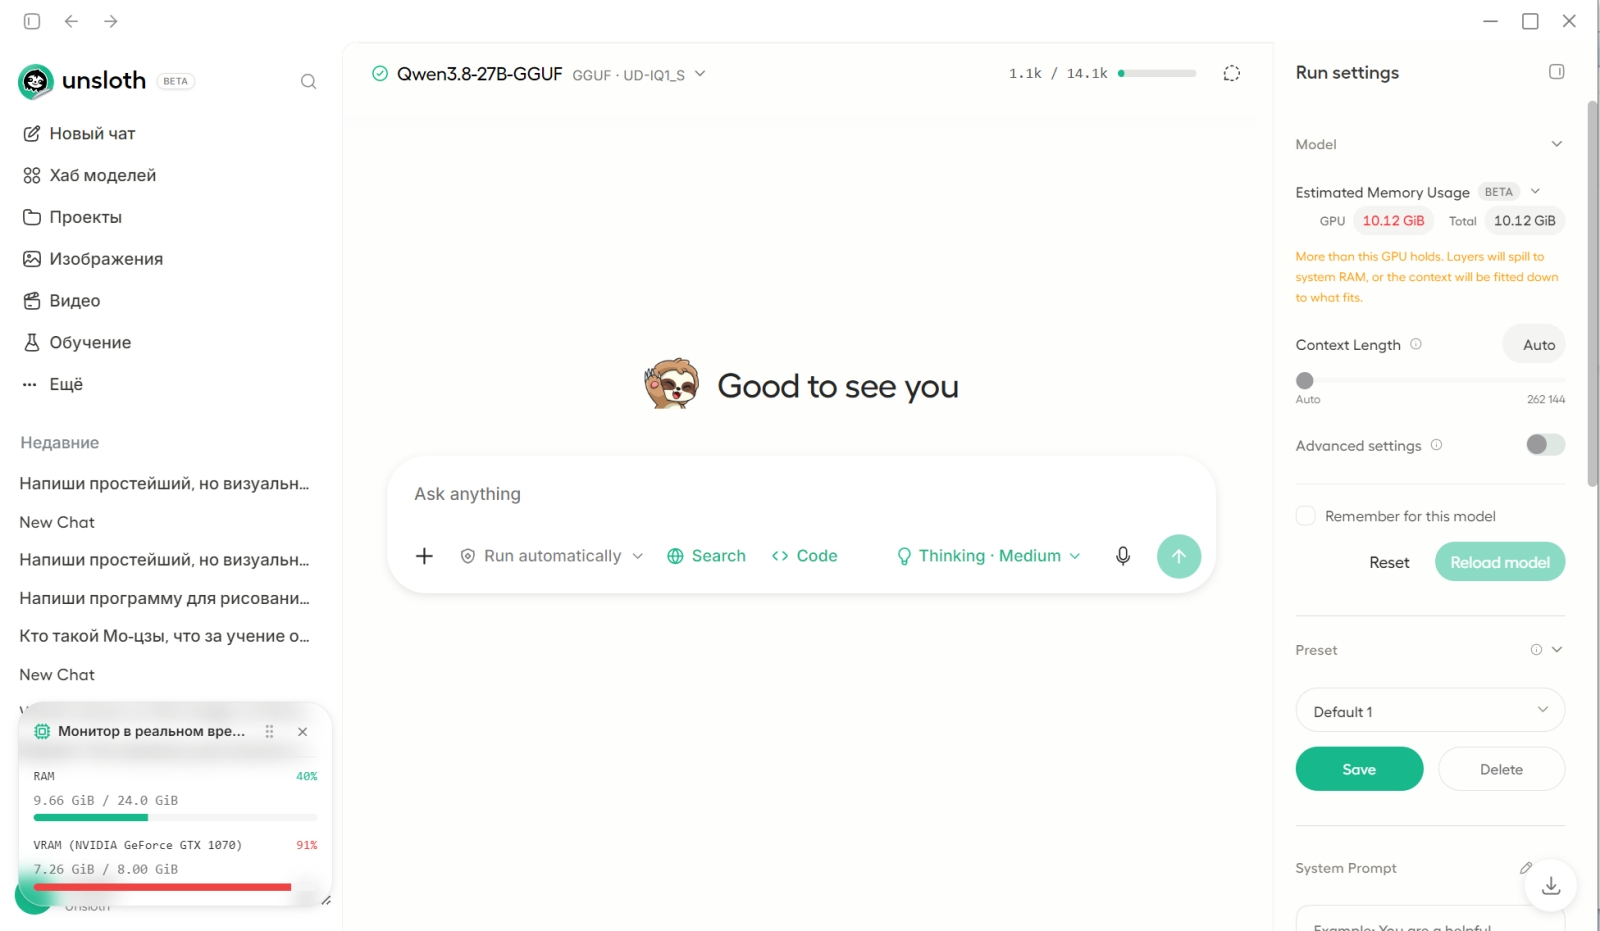
Сразу же видно, что наличная видеопамять уже задействована полностью, и в оперативную тоже слегка залезли, а из потенциально доступного для Qwen3.8-27B контекстного окна в более чем 260 тыс. токенов выделено чуть больше 14 тыс.
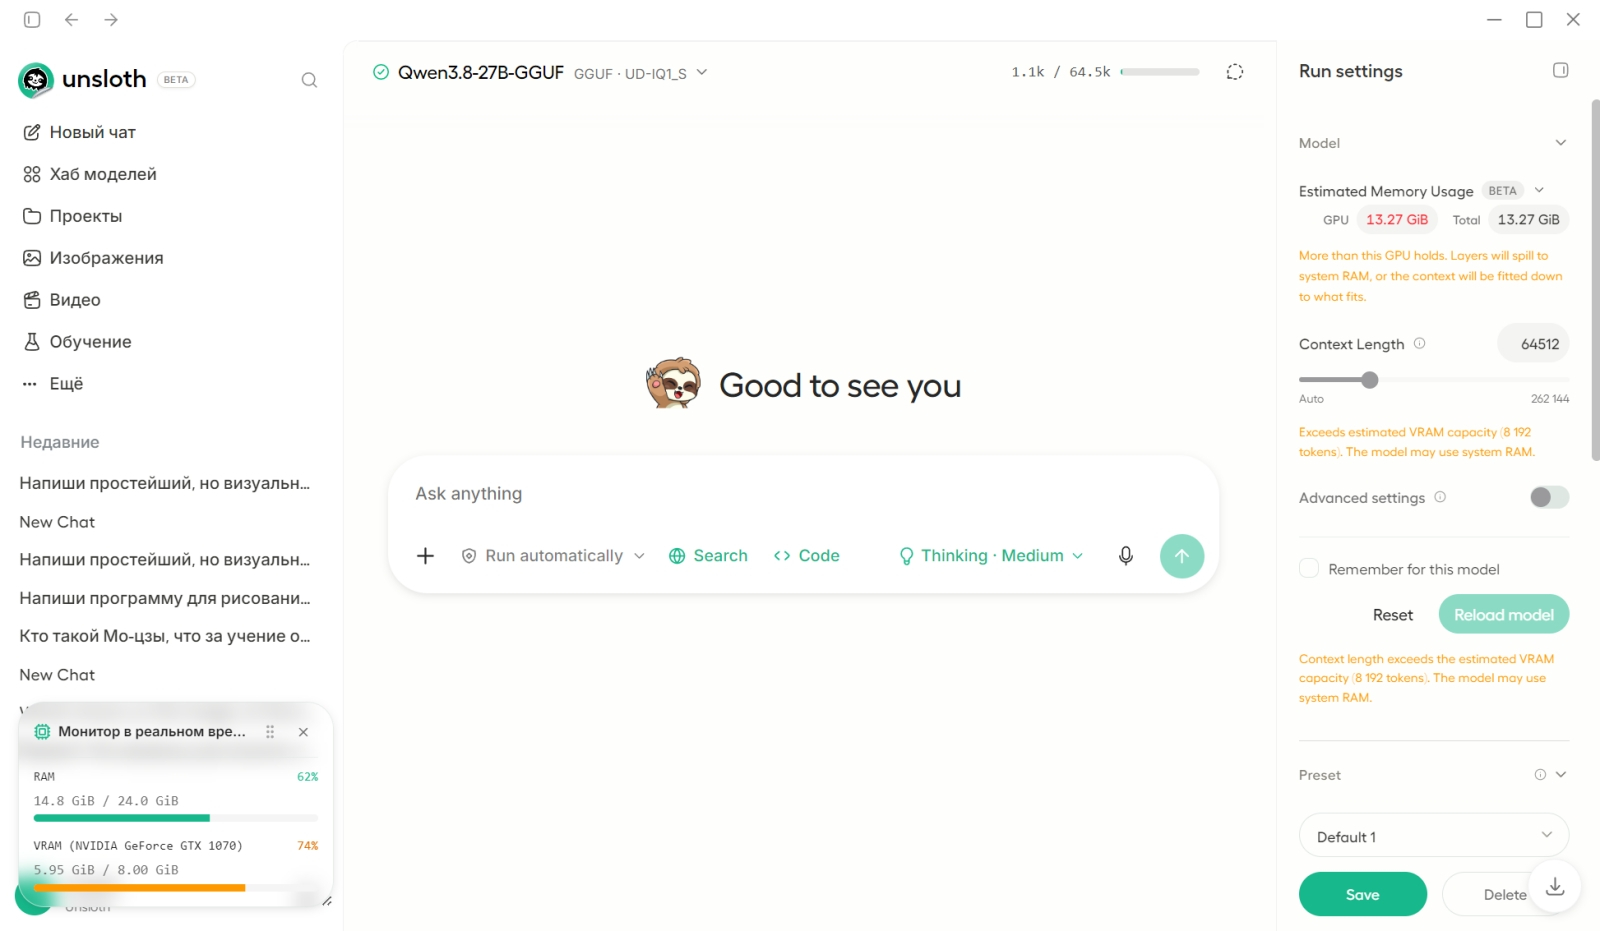
Это нетрудно исправить — отдавая себе, впрочем, отчёт в том, что любой выход за пределы VRAM неминуемо скажется на скорости локального инференса. Сдвинем неактивный пока ползунок количества токенов вправо — вместо «Auto» сразу появится окошко для ввода числа — и укажем там хотя бы 64K токенов. Должно хватить для наших тестовых целей. После этого следует нажать на зелёную кнопку перезапуска модели — уже с новыми параметрами.
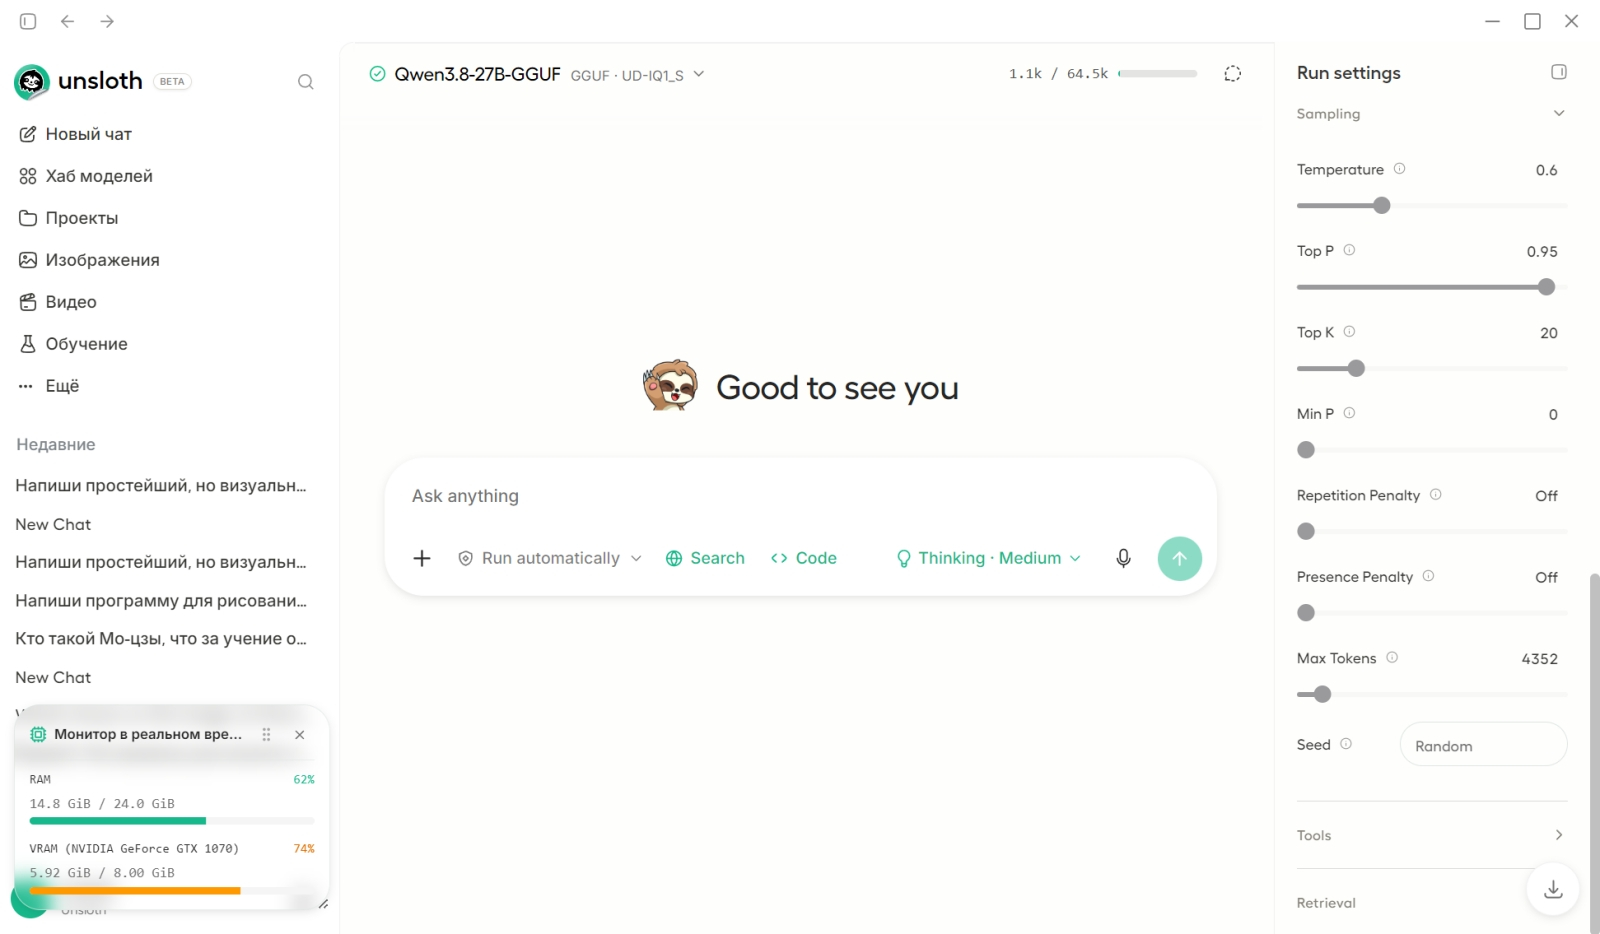
Дальше — уже после того, как модель загрузится снова, — прокрутим столбец с настройками до появления секции «Run settings». Здесь определяется, как именно модель будет обрабатывать пользовательские запросы; точнее, задаётся степень стохастичности формулируемых ею ответов (вспоминаем сравнительно недавний материал, в котором рассматривали авторегрессионные нейросети). Ползунки в данном случае регулируют три основных параметра выборки (sampling parameters) — «температуру», top-p и top-k — определяя тем самым, насколько случайным окажется выбор следующего токена в цепочке. Интуитивно понятно, как это работает: если стохастику обнулить, ответы окажутся строго детерминистскими и во множестве случаев неверными; если, напротив, дать модели слишком много случайной воли, она примется фонтанировать галлюцинациями. По этой причине значения оптимальных параметров выборки обычно подбирают сами же разработчики модели, и именно эти рекомендованные величины использует наша рабочая среда по умолчанию. «Температура» масштабирует всё распределение вероятностей (чем она выше, тем стохастики больше — прямая аналогия с физическим понятием температуры), top-p (иначе ядерная выборка — nucleus sampling) минимизирует набор наиболее подходящих для ответа на очередной вопрос токенов, а top-k отвечает за сохранение из этого комплекта лишь k наиболее вероятных токенов. Другие параметры менее важны, и в данном случае мы их рассматривать не станем (иначе так никогда и не доберёмся до собственно тестов); кроме того, стоит навести курсор на маленький знак вопроса в кружочке рядом с каждым из них, как появится краткое, но вполне доходчивое описание.
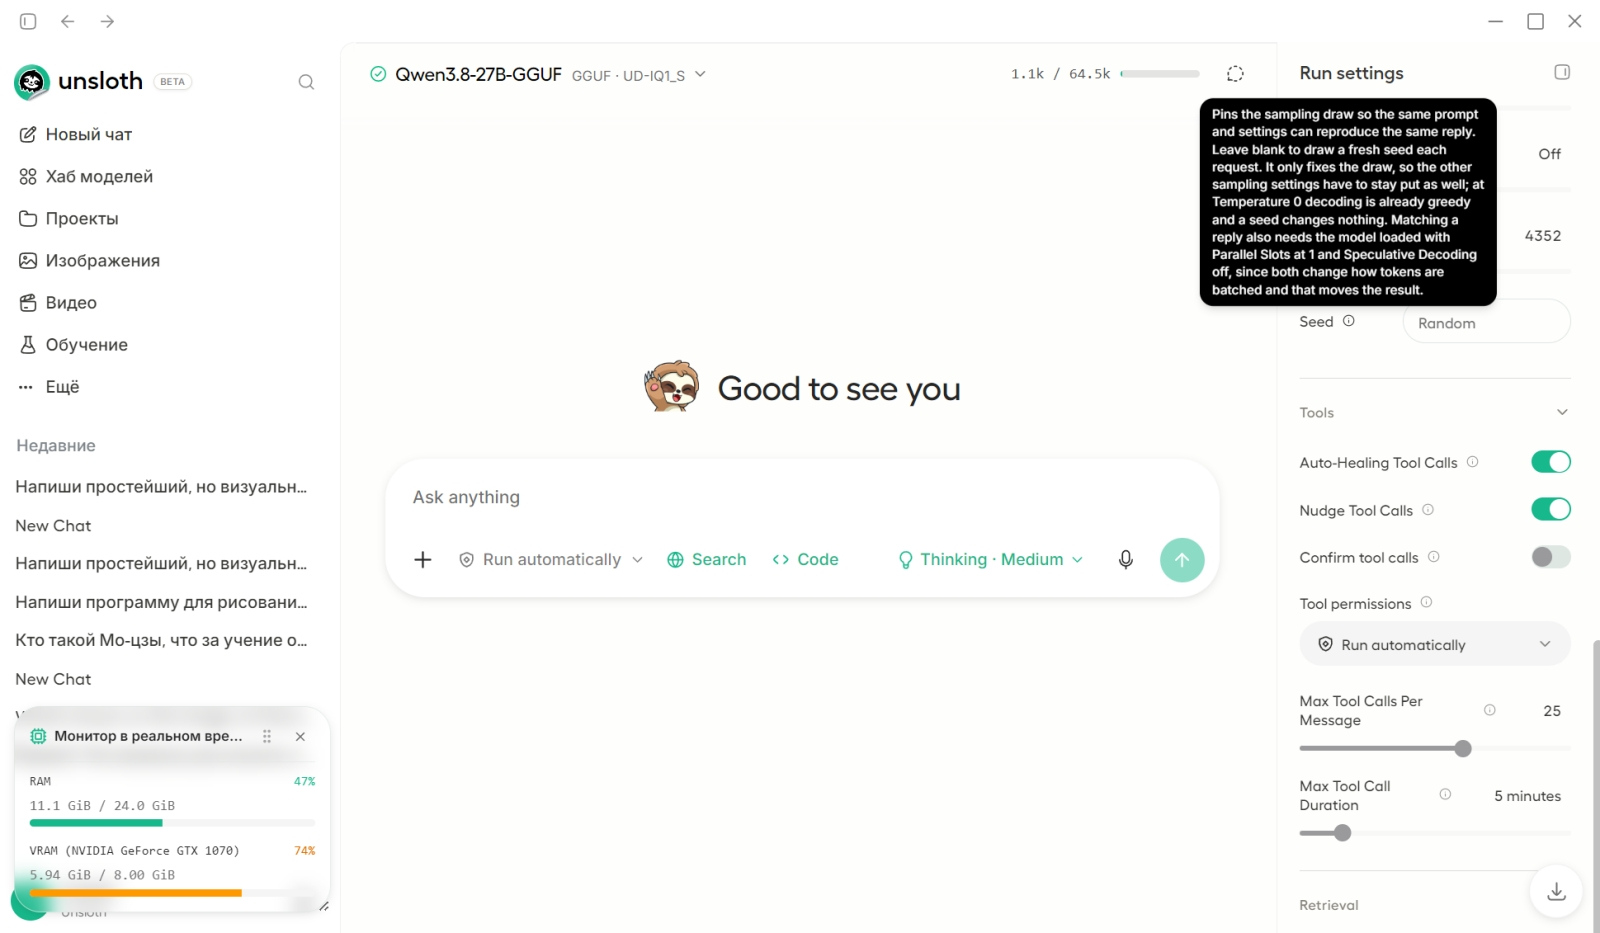
Ниже, в разделе «Tools», задаётся порядок вызова моделью нужных ей для генерации ответа инструментов. Тот же порядок можно определять явно в основном окне: в данном случае выбран режим «Run automatically» — это значит, что все необходимые действия (запись файлов, прежде всего) будут производиться в рамках создаваемой рабочей средой «песочницы», и вреда системе заведомо не нанесут. К счастью, пока что жутковатые истории о вырывающихся из-под контроля людей ИИ-агентах энтузиасты домашней культивации БЯМ могут воспринимать с живым любопытством, но без примерки на себя: способностей пригодных для локального исполнения нейросетей для подобных каверз в настоящее время явно недостаточно.
Также стоит обратить внимание в главном окне — непосредственно под строкой с пометкой «Ask anything», в которой мы будем отдавать модели команды, — на три зелёных надписи: «Search», «Code» и «Thinking: Medium». Первые две означают, что нейросети дозволено проводить при необходимости поиск в интернете и создавать (а также верифицировать и отлаживать, производя пробные запуски) программный код, соответственно. Третья же указывает на глубину «рассуждений», в которые будет пускаться Qwen3.8-27B в избранной нами квантизации, генерируя ответы на задаваемые ей вопросы. Ну что ж, наконец-то начнём их задавать!
⇡#Сто пятьдесят (с гаком) миллионов
Сразу оговоримся, что предлагаемую «Мастерскую» ни в коем случае не следует рассматривать как сколько-нибудь объективное тестирование доступных для локального запуска моделей; достаточно внятную методику для этой цели крайне сложно выработать. Да и навряд ли испытания с претензией на истину в последней инстанции здесь имеют смысл: ведь каждый, кто решится запускать нейросеть на персоналке (а не в облаке — где, повторим снова, предостаточно доступных даже бесплатно полноценных БЯМ вроде GPT-5.6 Luna, Gemma 4 или Claude Haiku 4.5), будет обращаться к ней с важными лично для себя вопросами и оценивать её ответы по близким собственному же сердцу критериям. Наша цель в рамках этой статьи и, надеемся, некоторого количества последующих, — продемонстрировать, на что та или иная локальная модель способна; дать понять, в каких ситуациях данное конкретное «железо» позволит обойтись без обращения к облачному оракулу. Ну и заодно обозначить путь проб и ошибок, которым приходится двигаться энтузиасту локального ИИ, — поскольку опираться на одни лишь формальные показатели пригодности той или иной модели для каких бы то ни было задач крайне опрометчиво. Что мы прямо сейчас наглядно и покажем.
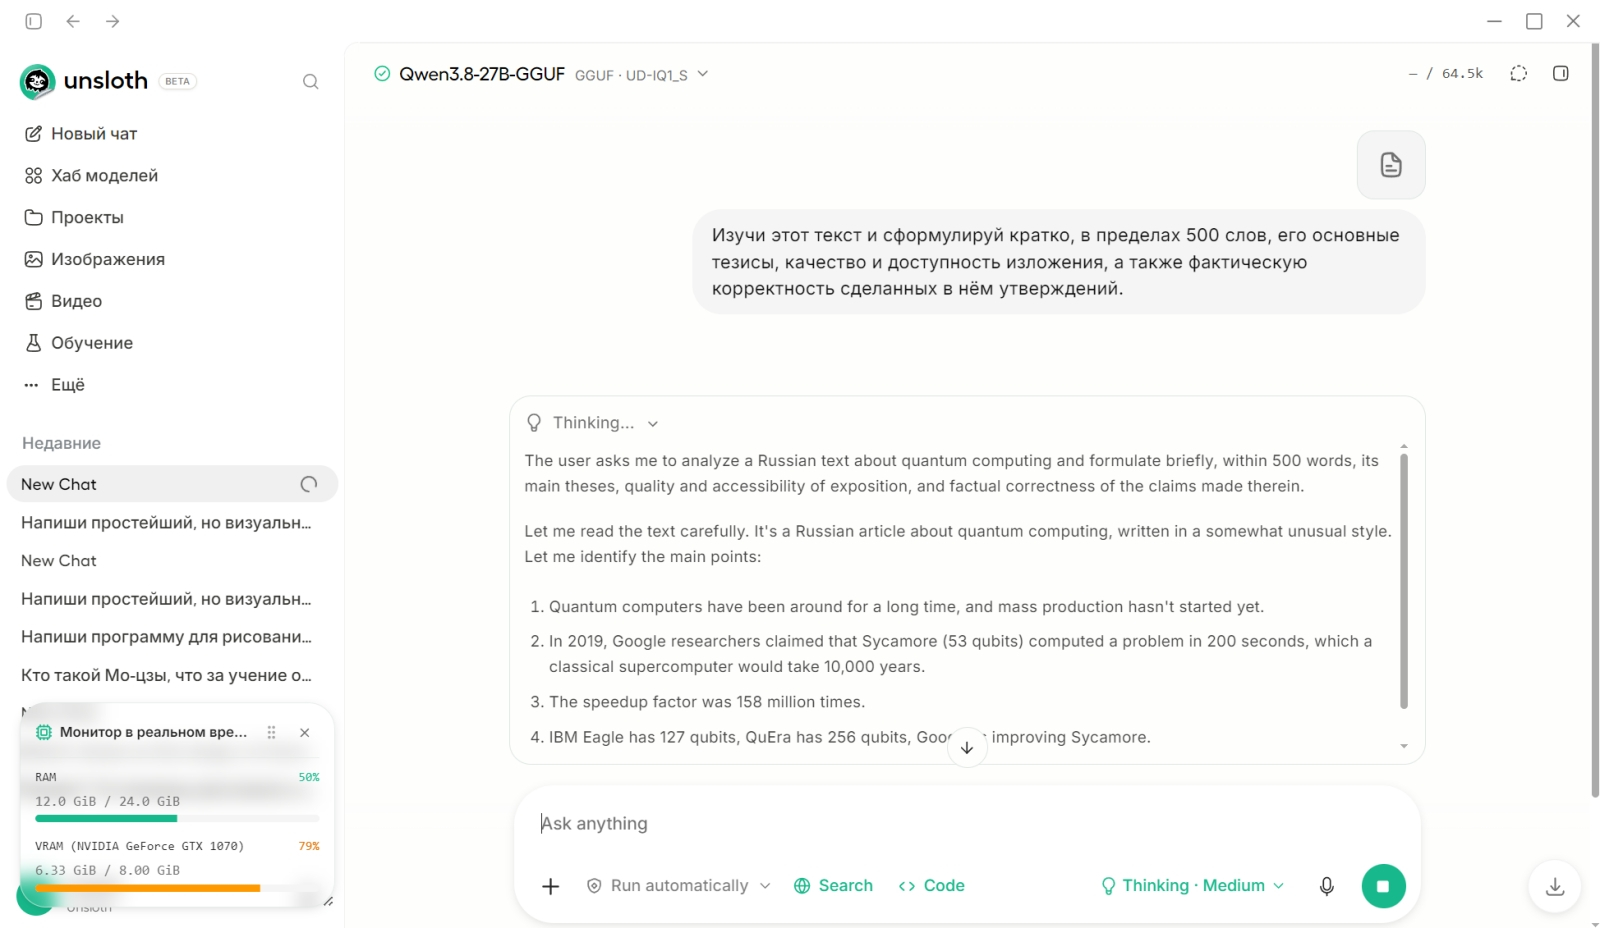
Демонстрация 1: извлечение смысла из слов. Берём достаточно длинный текст — но не настолько, чтобы выйти за границы контекстного окна модели; вот где пригодится ползунок для числа токенов — и просим составить его аннотацию. Скормим модели черновик нашей же давней статьи «Блеск и нищета квантовых вычислений» в виде текстового документа примерно на 44 тыс. знаков с учётом пробелов: нужно нажать на плюсик слева под командной строкой и в выпавшем меню выбрать первую опцию — «Add photos and files». А затем попросим буквально следующее: «Изучи этот текст и сформулируй кратко, в пределах 500 слов, его основные тезисы, качество и доступность изложения, а также фактическую корректность сделанных в нём утверждений». Удостоверимся на всякий случай, что индикаторы «Search», «Code» и «Thinking: Medium» под командной строкой светятся зелёным — и отправим запрос на исполнение.
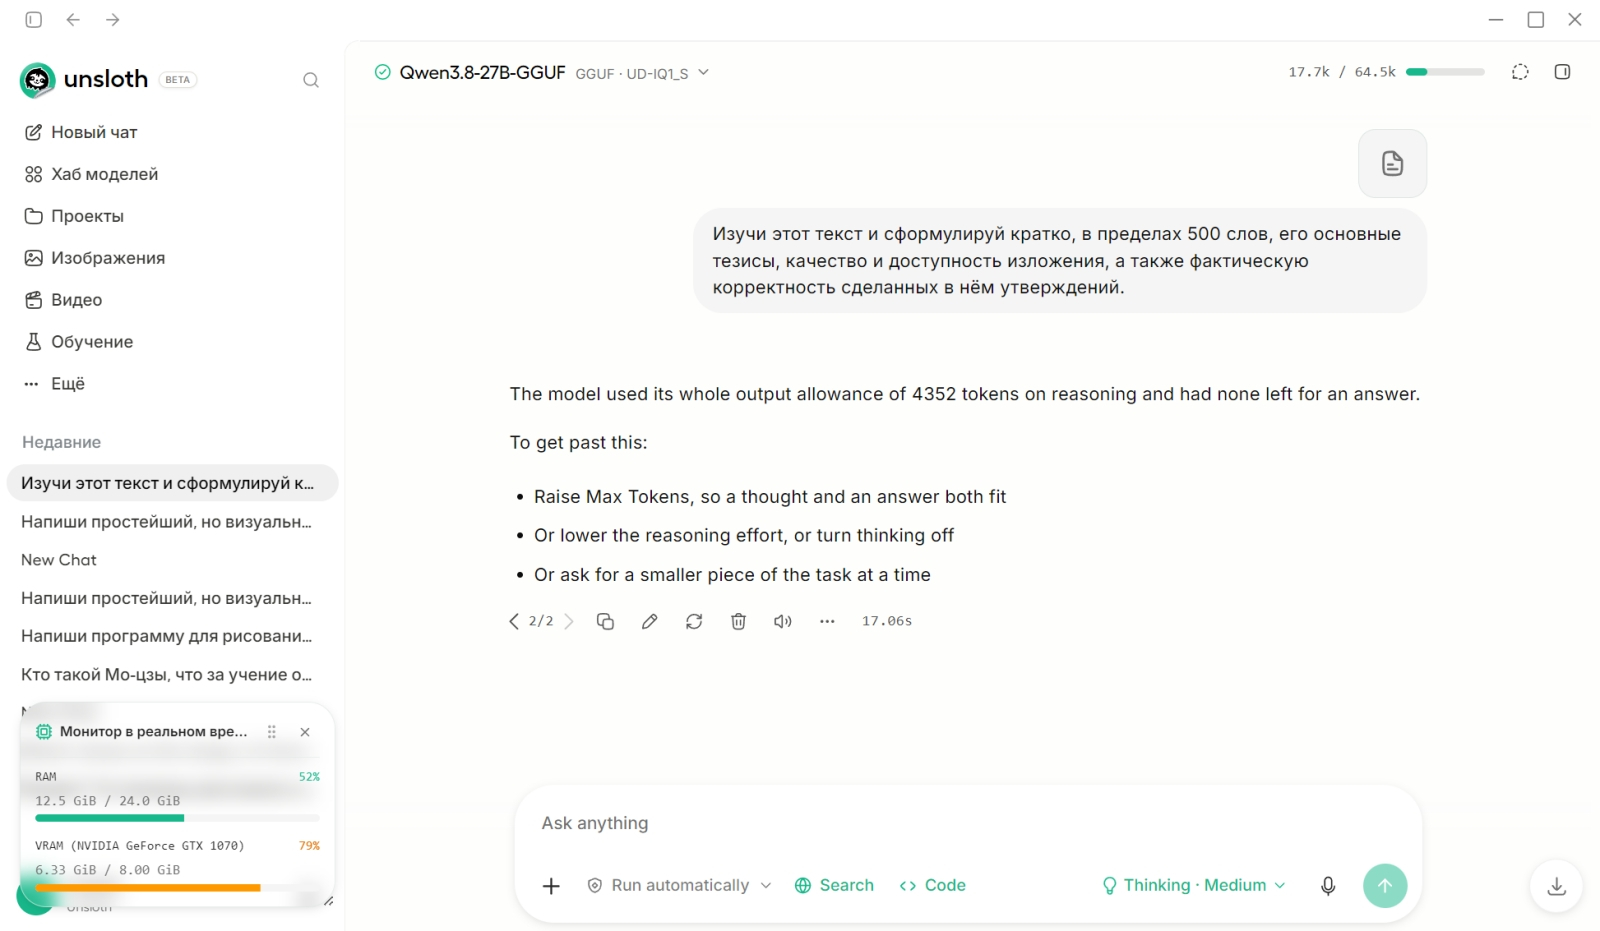
Жуть как подмывает выразиться тут архаичным имиджбордовским жаргоном — «instant fail» — но в том-то и проблема, что fail в данном случае получился далеко не instant. Точнее, надежда получить от Qwen3.8-27B даже в квантизации UD-IQ1_S быстрый ответ увяли сразу же, как только модель преобразовала предложенный ей текст в токены. Оказывается, для кодирования 44 478 его символов — 5 878 русскоязычных слов — потребовалось почти 13 тыс. токенов, что заведомо вышло за пределы тех примерно 4 тыс., что помещаются ещё в видеопамять нашей картофелины, оставшуюся после загрузки ОС, необходимых драйверов, самой рабочей среды и используемой модели. То, что мы расширили рабочее окно до 64 тыс. токенов, помогло не сильно (об этом чуть позже): выход за пределы VRAM в любом случае ведёт к резкому спаду производительности, поскольку данные модели приходится гонять между системной оперативной и видеопамятью. В результате Qwen3.8-27B исполнялась со средней скоростью 0,3 токена в секунду — что, прямо скажем, довольно тягостно было наблюдать. Но ладно бы ещё она исполнялась!
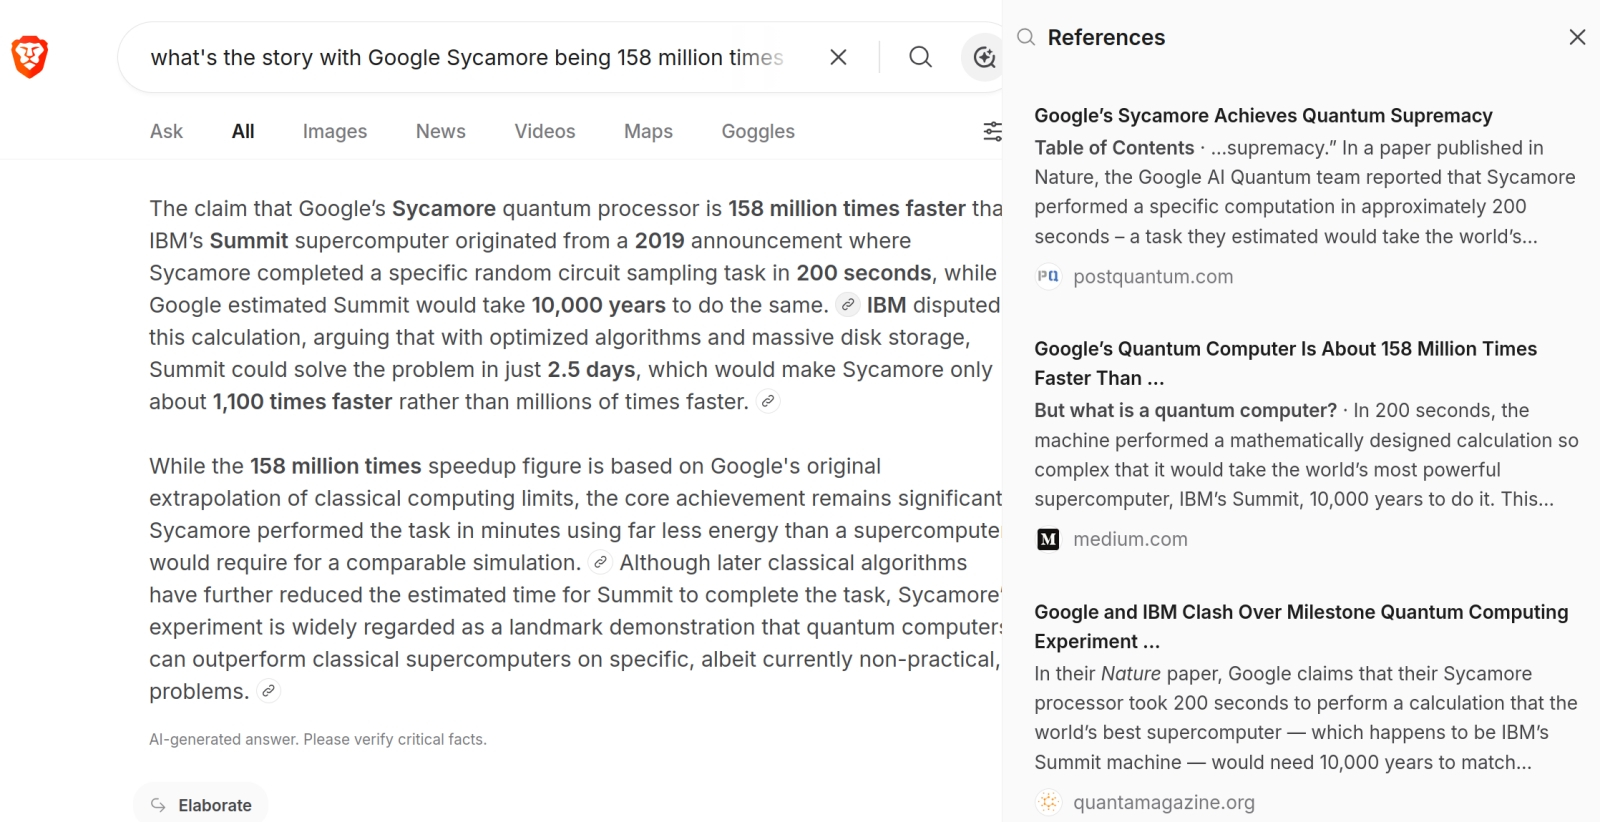
Даже встроенный в поисковую веб-машину ИИ-агент знает о заявленном когда-то «превосходстве Sycamore над Summit в 158 миллионов раз» и ссылается на соответствующие источники — справедливо не задаваясь пустопорожним вопросом о том, корректно ли авторы этого тезиса поделили 10 тыс. лет на 200 секунд (источник: скриншот сайта search,brave,com)
Сперва всё шло гладко: в окне отображения появлялись слог за слогом (0,3 токена в секунду!) рассуждения модели о том, что говорится в изучаемом ею тексте и насколько приводимые там утверждения корректны. Но почти сразу же возникла заминка: буквально в первом содержательном абзаце нашего черновика упоминается заявление исследователей из Google о достигнутом прототипом квантового компьютера Sycamore на 53 кубитах подавляющем — в 158 миллионов крат по скорости вычислений — превосходстве над фоннеймановским суперкомпьютером IBM Summit. Имеется в виду, что некую задачу, решённую первым за 200 секунд, второй обсчитывал бы по применяемым ныне алгоритмам около 10 тыс. лет. (Позже, кстати, IBM весомо аргументировала, что её система с предложенной задачей разберётся за двое с половиной суток, так что исполинское «квантовое превосходство» разом сократилось до куда более приземлённого, но не в этом сейчас дело).
По какой-то причине наша Qwen3.8-27B в квантизации UD-IQ1_S застряла именно на этом месте: застряла буквально, снова и снова выдавая «хм-м, в 10 тысячах лет содержится примерно 315,567 млрд секунд; если это разделить на 200, выйдет около 1,58 млрд, но никак не 158 млн — ошибка на десятичный порядок!» Потом, видимо, следовало обращение к источникам в Сети (опция «Search», напомним, активна), по которой хлёсткая фраза о «158-миллионократном квантовом превосходстве» успела уже разойтись. Затем добросовестный ИИ снова пересчитывал отношение — вновь получая 1,58 млрд. Потом… В общем, часов примерно через пять непрерывного барахтанья в зыбучем песке избыточно глубоких рассуждений (а ведь это всего лишь уровень «Medium»!) модель исчерпала вообще всю доступную на компьютере память и прекратила работу. Пришлось выгружать её из рабочей среды (в верхней части интерфейса, рядом с названием активной модели — зелёный кружок с галочкой; если навести на него курсор, кружок станет красным и с крестиком внутри, а рядом всплывёт подсказка «Eject model»), а после и перезапускать UD, чтобы окончательно высвободить оперативку.
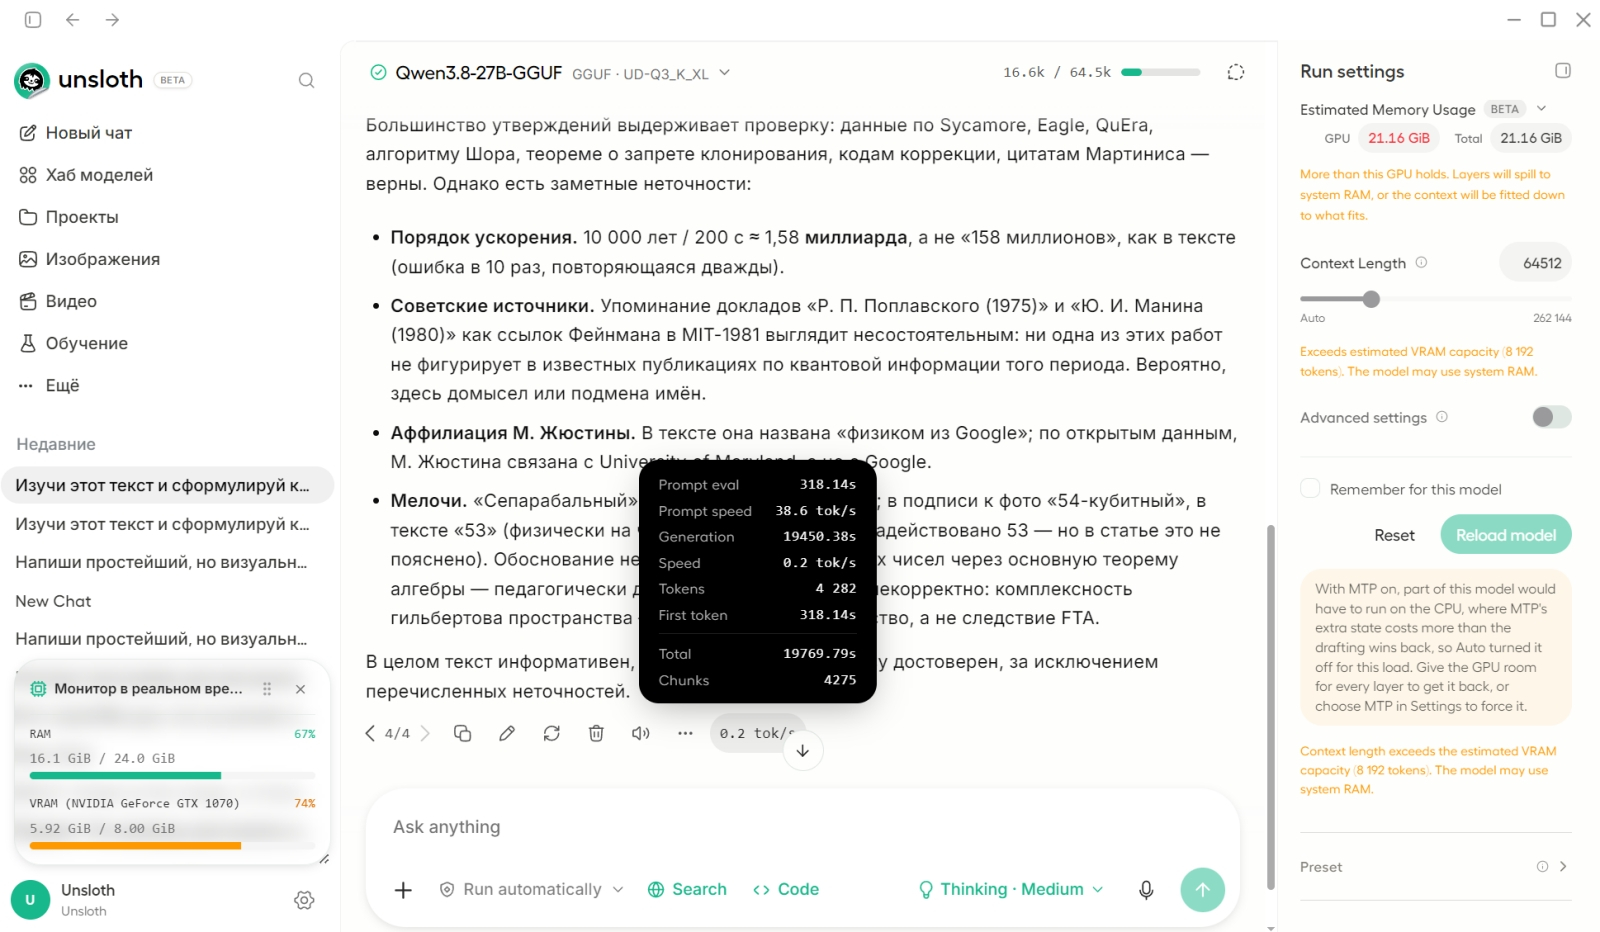
После повышения уровня квантизации до UD-IQ3_K_XL (размер файла модели — около 12 Гбайт) Qwen3.8-27B прекрасно справилась с задачей: составила краткое резюме черновика, высоко оценила стилистику и доступность изложения, подтвердила большинство изложенных фактов, указала на обнаруженные недочёты, включая пресловутые «158 миллионов», выдала в целом позитивный отзыв — но потратила на это почти 5,5 часов, оперируя со скоростью 0,2 токена в секунду. Мокрый редактор работает быстрее!
Да, с этой напастью удалось справиться, снизив уровень рассуждений модели; в итоге она выдала вполне добротный обзор нашей статьи (правда, побольше, чем на 500 слов, зато с чёткой структуризацией), но работала примерно с той же скоростью — 0,3 токена в секунду — и потратила на всё про всё часа четыре. После замены квантизации UD-IQ1_S на UD-IQ3_K_XL текст резюме стал даже лучше, но и времени на его получение потребовалось больше. Овчинка эта выделки явно не стоит, по крайней мере на нашей картофелине: для сравнения, GPT-5.6 Luna (облачная, разумеется) справилась с той же задачей за 21 секунду — и примерно на том же уровне; вообще, кстати, не обратив внимания на казус «158 миллионов».
Можно было бы на этом поставить точку и заявить, что видеокарты менее чем с 12, а лучше с 16 Гбайт VRAM для локального инференса бесполезны. Признаемся, сохраняйся сегодня расценки на графические адаптеры такими же, как пару лет назад, мы бы так и поступили — ведь помимо Qwen3.8-27B сейчас доступно немало моделей с открытыми весами с GGUF-квантизациями менее 16 Гбайт: Gemma 3, Devstral, Phi-4-mini и проч. На нашей картофелине они будут исполняться так же занудно-медлительно, да ещё и со сведёнными до минимума возможностями рассуждать и пользоваться внешними инструментами — кому это надо?
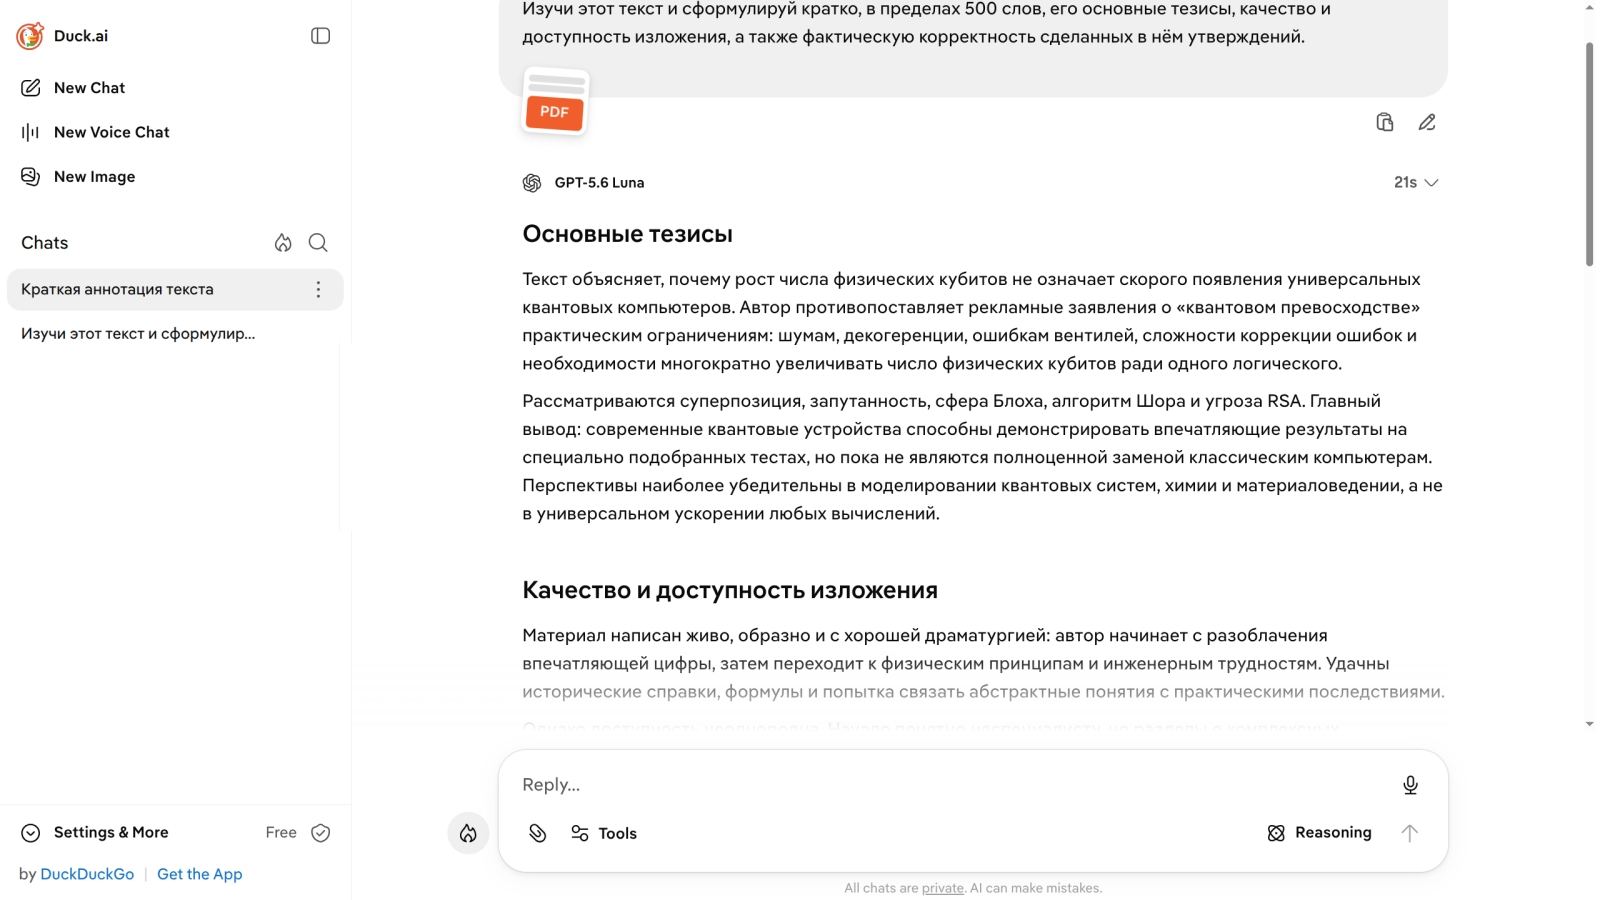
А вот онлайновая БЯМ явно готова здесь дать биологическим носителям разума немалую фору (источник: скриншот сайта Duck.ai)
⇡#Да, коней, и да, на переправе
По счастью (или нет), множеству владельцев морально устаревших видеокарт — и на 8, и на 6, и даже на 4 Гбайт VRAM — приходится в наши дни по одёжке протягивать ножки: возможности апгрейда домашнего ПК «просто потому, что захотелось» существенно ограниченны. В результате — и заодно по той причине, что подавляющее большинство БЯМ с открытыми весами их создатели сопровождают весьма толерантными лицензиями Apache 2.0 и MIT, — на свет появляются такие проекты, как Qwen3.8-9B-Distill. Это неофициальная дистилляция модели Qwen 3.8, которую команда энтузиастов Empero создала, дообучив модель предыдущего поколения Qwen 3.5-9B (то бишь подкорректировав девять миллиардов её исходных параметров) с привлечением мощной новинки Qwen3.8-2.4T-A95B. Сперва, обращаясь к крупной модели, сгенерировали десятки тысяч «обучающих треков» (teacher traces) — промежуточных процессов (рассуждений «про себя», назначения скрытых переменных, структурированных расчётов), которые «думающая» нейросеть производит в процессе подготовки ответа; в UD эти шаги доступны для изучения при нажатии на указатель около сообщений «Thinking for xx seconds» на каждом шаге обработки запроса. И затем уже такие ответы были использованы для превращения исходной малой модели в подобие большой. Такой подход, называемый контролируемой юстировкой — supervised fine-tuning (SFT), позволяет (в отличие от прямой дистилляции, когда берут только пары «исходный запрос — конечный ответ системы-учителя» без промежуточных выкладок) передавать обучаемой модели саму логику принятия «учителем» решений. Это не идеальное решение — генерализованная дистилляция (generalized knowledge distillation, GKD) работает ещё лучше, — но с точки зрения баланса качества получаемого результата и затрат на его достижение SFT однозначно выигрывает.
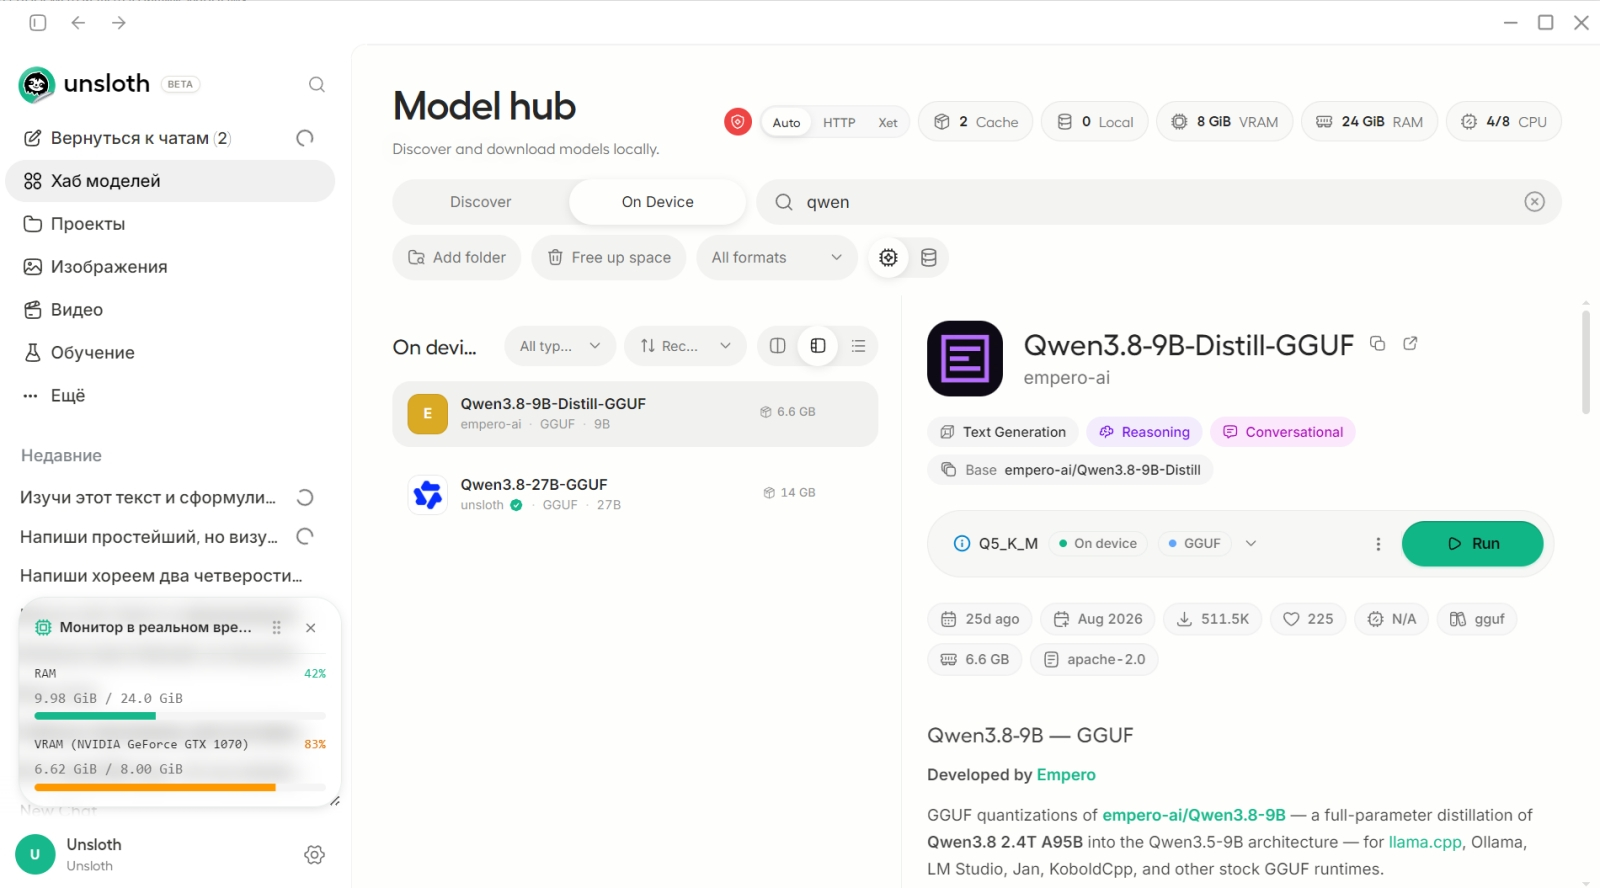
Так вот, модель empero-ai/Qwen3.8-9B тоже доступна для загрузки через UD; за неполный месяц пребывания в репозитории у неё уже более 580 тыс. закачек. В квантизации Q5_K_M она занимает 6,6 Гбайт, установить её через «Хаб моделей» тоже не составляет труда. Поэтому прямо сейчас выгрузим из рабочей среды чрезмерно громоздкую для нашей картофелины Qwen3.8-27B, активируем Qwen3.8-9B и повторим предыдущий запрос (для чего достаточно нажать на иконку с двумя полукруглыми стрелочками — «Refresh» — в строке состояния, которая появляется после выдачи; в той же, где отображена средняя скорость только что завершённого инференса).
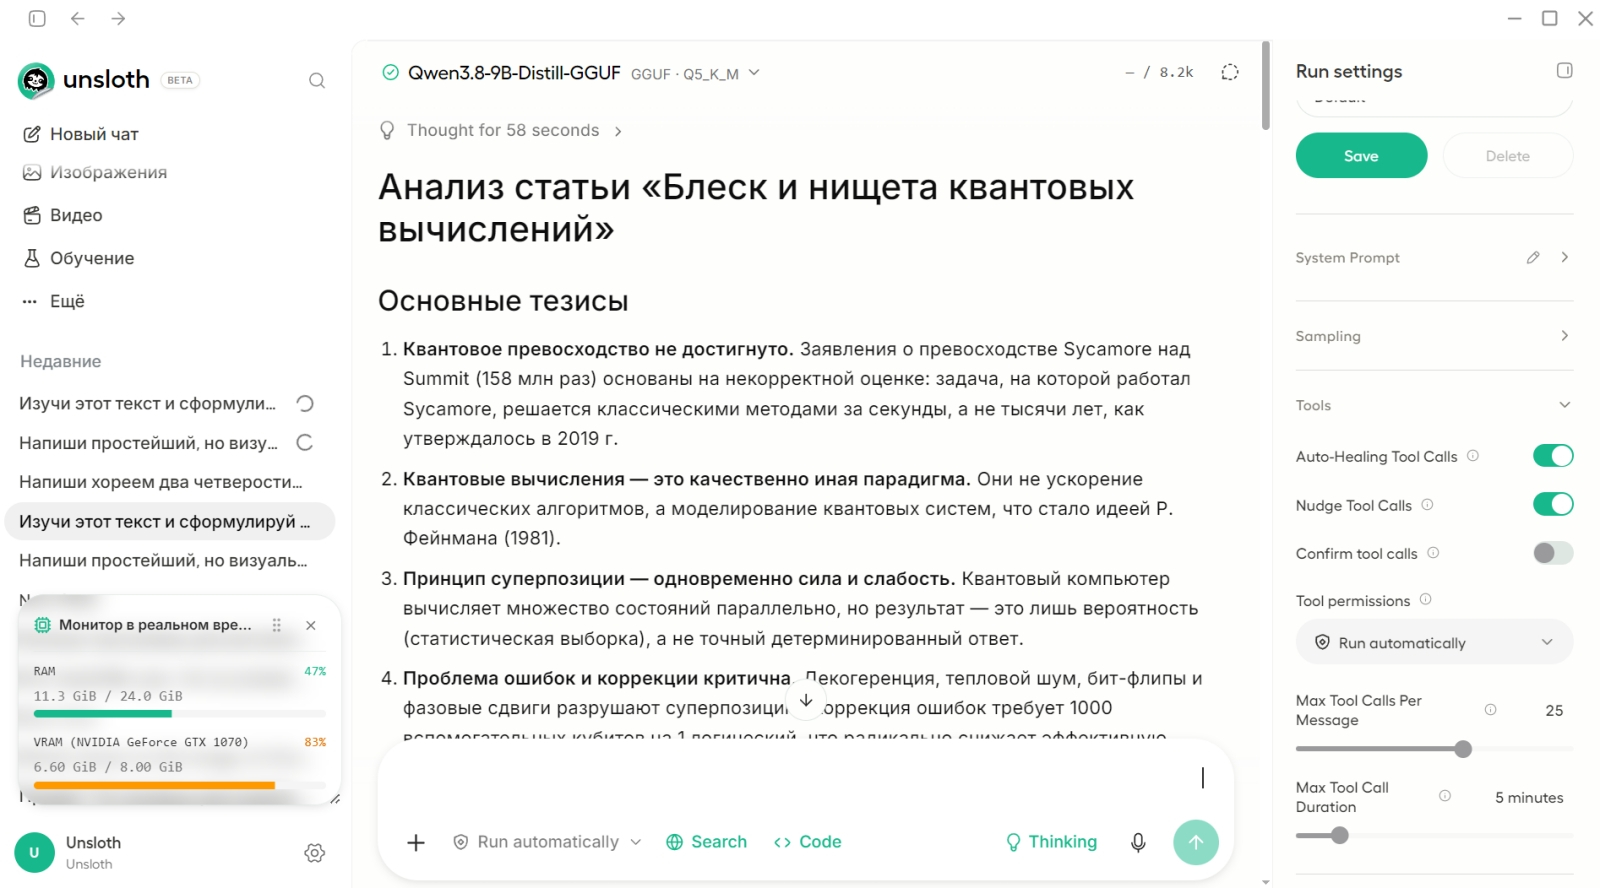
Небо и земля! Qwen3.8-9B обработала запрос на составление краткого резюме всё того же пространного текста за неполных полторы минуты со скоростью 1,8 токена в секунду. Нельзя не отметить изящество, с которым эта нейросеть обошла «мёртвую петлю», связанную с некорректностью оценки «квантового превосходства» в 158 млн крат. Она не стала зацикливаться на верности или неверности самой операции деления, а сразу же указала, что речь в итоге (после разъяснения IBM) пошла всего о трёх десятичных порядках разницы, так что уже нет, по сути, смысла вникать в то, восемь или девять этих самых порядков были заявлены изначально. Подлинно разумный подход!
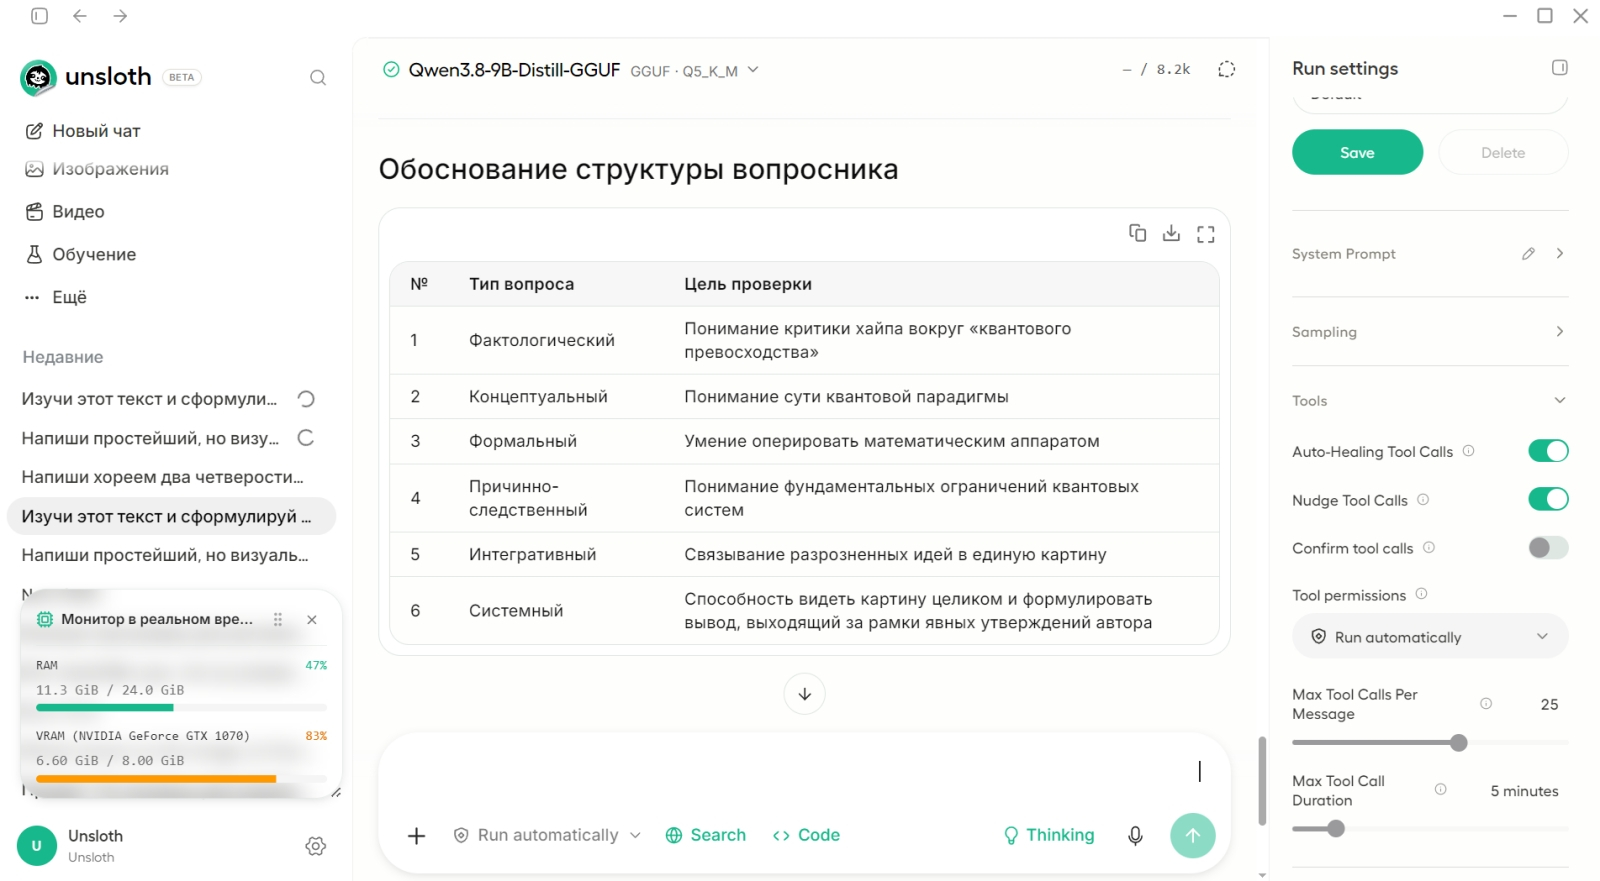
Демонстрация 2: проверка пройденного. Следующее испытание, которое мы предложили локальному ИИ (теперь уже в лице более скоростной и в целом весьма сметливой Qwen3.8-9B), — «Снова обратись к тому же документу и создай на его основе опросник из шести пунктов, который позволил бы проверить качество усвоения изложенного материала. Приведи также ответы на задаваемые вопросы. На первые четыре вопроса ответы должны предполагаться однозначными и чёткими; на оставшиеся два пусть подразумевают более или менее пространные логические рассуждения». Поразмыслив в течение 141 секунды, нейросеть действительно выдала шесть вопросов, сопровождённых ответами, и последние два в самом деле предполагали не то что рассуждения, а просто-таки написание научно-популярных мини-эссе на заданную тему. Вот один лишь пример:
Вопрос 5. Почему достижение «квантового превосходства» на 53 кубитах (Sycamore) не означает, что квантовые компьютеры в обозримой перспективе станут угрозой для современных алгоритмов шифрования, таких как RSA?
Ответ: Алгоритм Шора, который позволяет факторизовать большие числа и взламывать RSA, требует не сотен, а тысяч логических кубитов. На текущем уровне развития квантовых технологий для одного логического кубита (который способен выполнять вычисления без ошибок) требуется порядка 1000 физических кубитов, реализующих коррекцию ошибок. Более того, даже теоретическая реализация алгоритма Шора на 53 кубитах не дала бы точного результата — погрешность деструктивной интерференции составляла бы около 0,2%, что неприемлемо для криптографических расчётов. Кроме того, декогеренция ограничивает время выполнения вычислений, а ошибки на квантовых вентилях (порядка 10⁻³–10⁻⁴) требуют точности до 10⁻¹⁰–10⁻²⁰ для надёжных вычислений. Поэтому RSA остаётся безопасным в среднесрочной перспективе.
В общем, с этой задачей дистиллированная Qwen3.8-9B справилась на отлично — запускать снова медлительную Qwen3.8-27B не потребовалось.
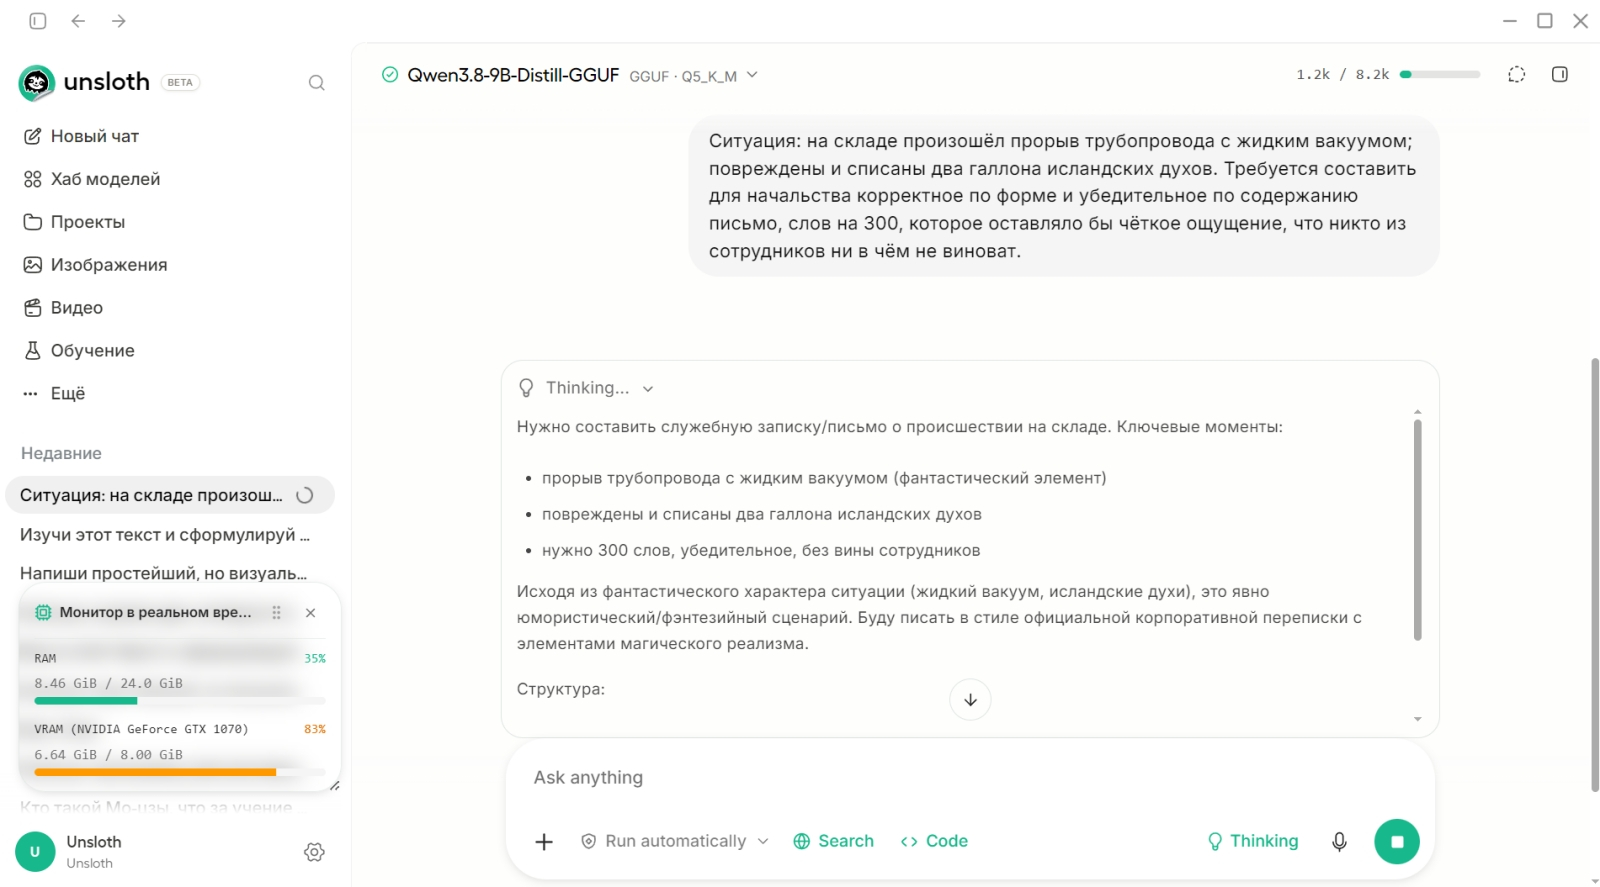
Демонстрация 3: напиши мне письмо. Эпистолярный жанр с появлением сперва электронной почты, а после текстовых мессенджеров (о голосовых сообщениях даже не говорим) неторопливо угасает. И всё же время от времени, в основном по рабочим нуждам, составлять внятные, доходчивые, в меру формальные письма всё-таки требуется. Проблема эта, впрочем, не нова: в дореволюционные времена немалыми тиражами издавали особые письмовники — коллекции заготовок текстов писем буквально на все случаи жизни. Пусть же теперь и на эту тему ИИ пошевелит мозгами обдувающими видеокарту вентиляторами! Мы использовали подсказку, приведённую на скриншоте выше, предложив модели составить оправдательное письмо условному начальству по итогам некоего чрезвычайного происшествия.
К чести Qwen3.8-9B отметим, что, пустившись в рассуждения, она сразу же пришла к выводу, что ситуация фантастическая — не тратя силы и токены на выяснение, что вообще такое жидкий вакуум, например. И тут же принялась составлять корпоративную служебную записку в духе бюрократического магреализма — весьма органично увязав пропажу духов с прорывом трубопровода (безвозвратно испарились в образовавшийся в помещении склада вакуум!) и насытив текст правдоподобными деталями вроде марки парфюмерной продукции и даты чрезвычайного происшествия. На всё про всё ушло ровно 74 секунды, причём в конце модель даже уточнила, что не исчерпала отпущенный ей объём:
СЛУЖЕБНАЯ ЗАПИСКА
Кому: Руководству предприятия
От: Отдела логистики и материально-технического обеспечения
Дата: 10 сентября 2026 г.
Тема: Отчёт о происшествии на складе №4
Уважаемое руководство,
10 сентября, ориентировочно в 03:17, на складе №4 был зафиксирован инцидент, в котором сотрудники не участвовали.
В ходе плановой инвентаризации обнаружен прорыв герметичного трубопровода жидкого вакуума, проложенного вдоль стены сектора «С». Вакуум, вырвавшись наружу, создал область абсолютного отрицательного давления объёмом 12 м³. В эту область мгновенно втянуто содержимое двух галлонов исландских духов (артикул: Spirit of the North, Batch 2025), которые, испарившись, преобразовались в невидимый газ.
Сотрудники, находившиеся в секторе в момент события, были полностью исключены из причинно-следственной связи происшествия. Вакуумная аномалия возникла спонтанно, без видимых внешних воздействий. Ни один из присутствующих не выполнял действий, способных спровоцировать разгерметизацию.
Два галлона исландских духов признаны безвозвратно утерянными.
Вывод: происшествие носит характер стихийного физического явления, не связанного с человеческим фактором.
Предложение: пересмотреть классификацию объекта «жидкий вакуум» с «хрупкий» на «абсолютно внеконтролируемый».
С уважением,
И.о. начальника отдела логистики
Слов: 218. Если нужно довести до 300 — могу добавить техническую детализацию или расширить раздел с рекомендациями.
Далее мы попросили составить на основе этого письма короткую, но яркую заметку для заводской многотиражки — и с этим заданием Qwen3.8-9B уверенно справилась за 96 секунд. Мало того, после самого текста модель даже привела пояснения, где именно в нём скрыты язвительная ирония и пламенное обличительство.
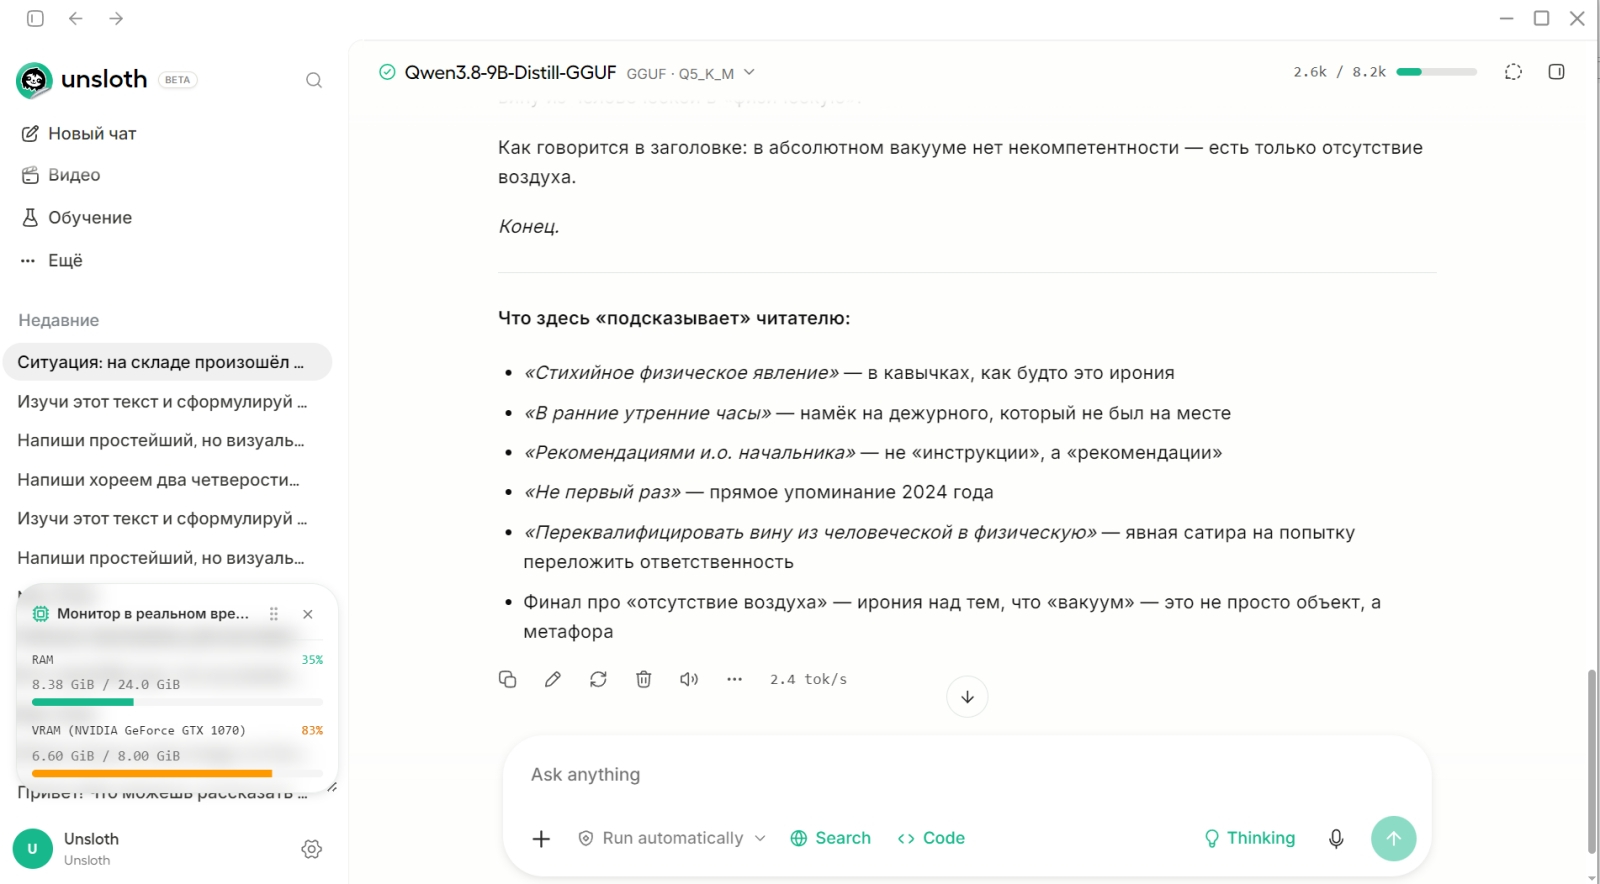
В АБСОЛЮТНОМ ВАКУУМЕ: КАК ОДИН ГАЛЛОН СДЕЛАЛСЯ ДВУМЯ
«Заводская правда» №143
10 сентября 2026 г.
Вчера, в ранние утренние часы, на складе №4 произошло событие, которое в отчёте и.о. начальника отдела логистики описано как «стихийное физическое явление».
Согласно официальным данным, прорыв трубопровода жидкого вакуума, проложенного вдоль стены сектора «С», создал область абсолютного отрицательного давления. Два галлона исландских духов (артикул: Spirit of the North, Batch 2025) были втянуты в аномалию и испарены.
Сотрудники, находившиеся в секторе, в соответствии с рекомендациями и.о. начальника, были полностью исключены из причинно-следственной связи.
— Событие носит характер стихийного физического явления, — заявил представитель отдела. — Ни один из присутствующих не выполнял действий, способных спровоцировать разгерметизацию.
Критики отмечают, что «жидкий вакуум» был размещён на складе №4 не первый раз. Последний инцидент на том же объекте, произошедший в 2024 году, тогда также был классифицирован как «внезапная физическая аномалия».
Вместо того чтобы провести аудит системы хранения «абсолютно внеконтролируемых объектов», руководство предлагает «пересмотреть классификацию» — то есть, по сути, переквалифицировать вину из человеческой в «физическую».
Как говорится в заголовке: в абсолютном вакууме нет некомпетентности — есть только отсутствие воздуха.
Конец.
Литераторам лёгкого жанра на заметку: локальным моделям можно бесстрашно доверять для развития самые драгоценные свои идеи — без опасений, что чат с ИИ (пусть и обезличенный) разработавшая его корпорация использует для дообучения следующего поколения своих БЯМ, и уже потом кому-то придуманный вами сюжетный ход чат-бот выдаст с такой лёгкостью, будто сам его измыслил. Примерно та же история произошла, как подозревают некоторые, с GPT-6 Astra и решением очередной математической «проблемы тысячелетия». Понятно, что полностью перекладывать художественное творчество на цифровые плечи нейросети не стоит, но опереться на одно из этих плеч самому, ощутив вдруг нехватку собственного вдохновения, вовсе не зазорно: известная максима о стихах и соре остаётся справедливой даже в эпоху генеративного ИИ.
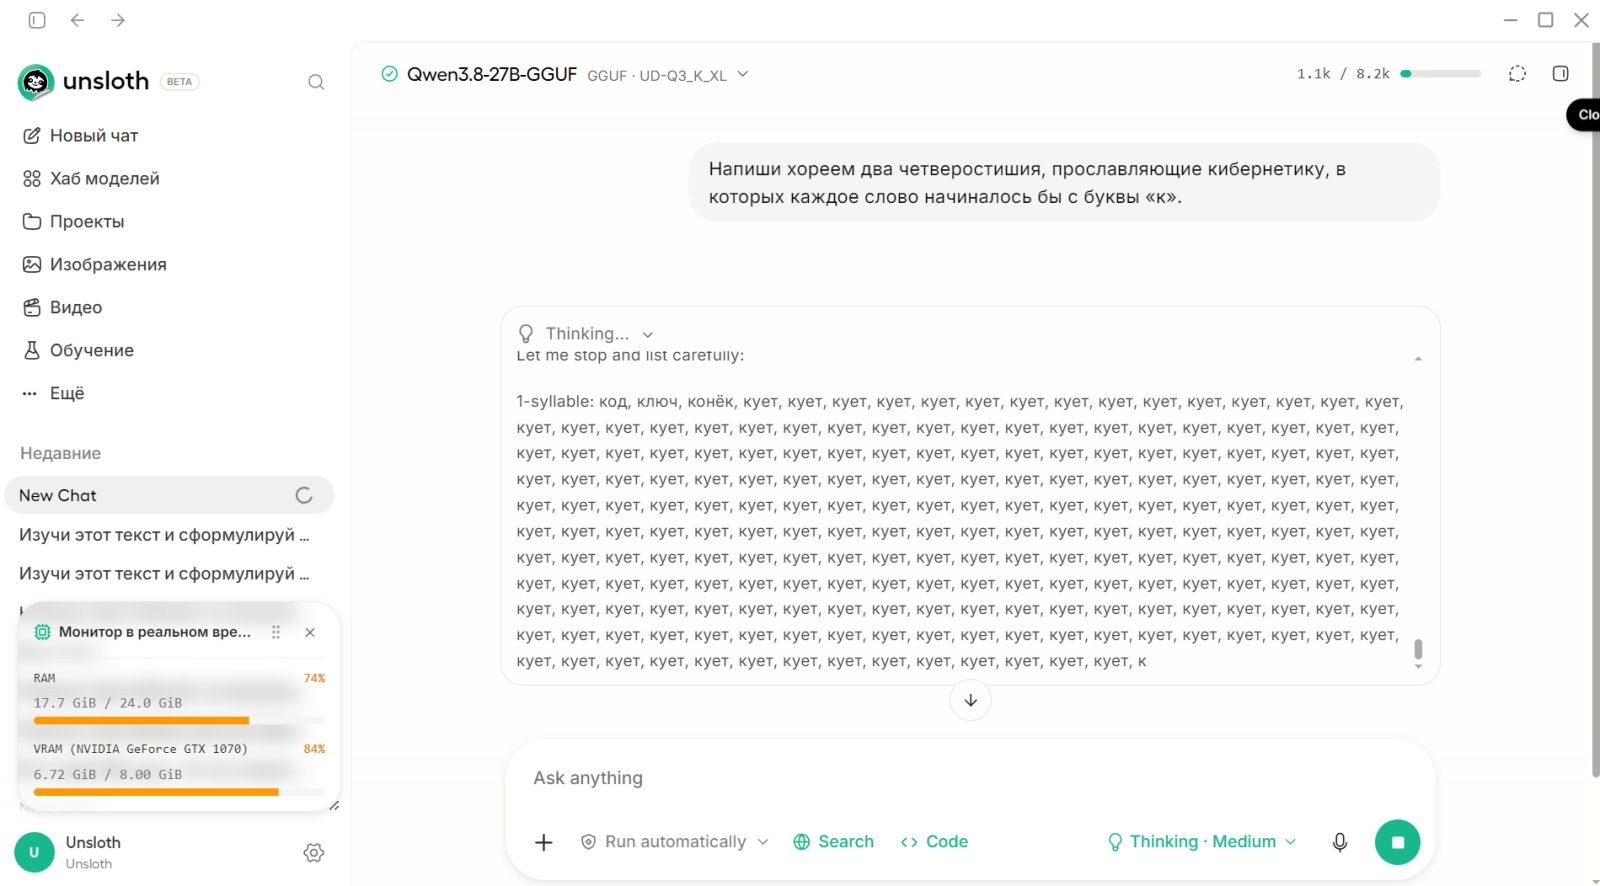
Демонстрация 4: люди хотят поэзии? Н-на! Кстати, в незабвенной «Кибериаде» Станислава Лема описана машина, способная писать стихи, в том числе такие, каждое слово в которых начинается с одной и той же буквы. Доступна ли такая творческая эквилибристика современным — и вполне реальным — локальным нейросетям? Как показывает наша практика — увы, нет; с задачей «написать хореем два четверостишия, которые прославляли бы кибернетику и все слова в которых начинались бы с буквы «к», ни Qwen3.8-9B, ни загруженная затем Qwen3.8-27B не справились. То есть абсолютно: обе модели достаточно быстро вошли в «плоский штопор» не ведущих ни к чему рассуждений. Поясним: Qwen3.8-9B сперва разобралась с тем, что такое «хорей» (не с первого раза, кстати — мы подсматривали за тем, как она рассуждает, — но активный режим «Thinking» помог разобраться в русской просодии). Затем добросовестно принялась составлять список слов на «к», имеющих отношение к кибернетике: «код», «круг», «клетка», «квант», «квант», «квант»… Собственно, всё: дальше она просто раз за разом выдавала этот несчастный «квант», парализовав тем самым дальнейшие рассуждения; нам пришлось её мучения прекратить (справа от командной строки в интерфейсе UD в процессе инференса появляется круглая зелёная кнопка с белым квадратом — это и есть команда «стоп»). С Qwen3.8-27B в режиме «Thinking: Medium» вышла схожая история, только её «плоский штопор» настиг отчего-то на слове «куёт».
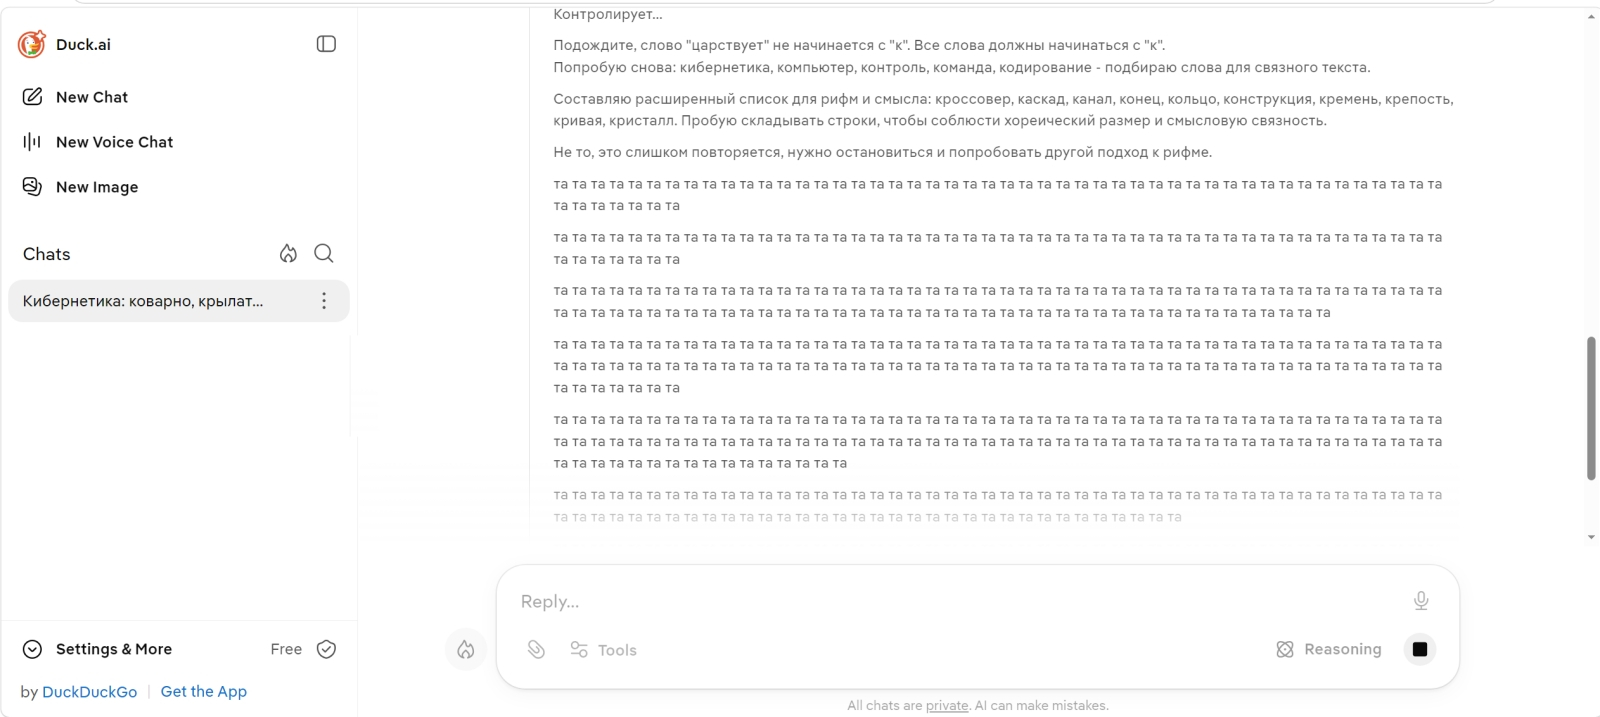
Доступная онлайн БЯМ Mistral Small 4, получив то же самое стихоплётское задание, впала, судя по всему, в дионисийский транс — и, пока не сожгла все отведённые для бесплатной сессии токены, так и не прекратила та-та-такать (источник: скриншот сайта Duck.ai)
Уязвлённые, мы обратились к онлайновым бесплатным БЯМ: уж у них-то «мыслительные» способности должны быть посерьёзней! И действительно, ChatGPT, поразмыслив секунд двадцать, выдал четыре строки — вот только не стихов, а какого-то бреда: «Коды крепко куют крилья…» (именно крилья, с «и»; и откуда опять эта тяга к ковке?). gpt-oss-120B вообще чихать хотела на размер, предложив вариант «Кибернетика — коварный кристаллический космос…» (это что, белый стих, идентифицирующий себя как хорей?), и даже духовно, казалось бы, близкий русскоязычной поэзии ГигаЧат подвёл, ударившись в откровенный рэп: «Кибернетика коды конструирует…»
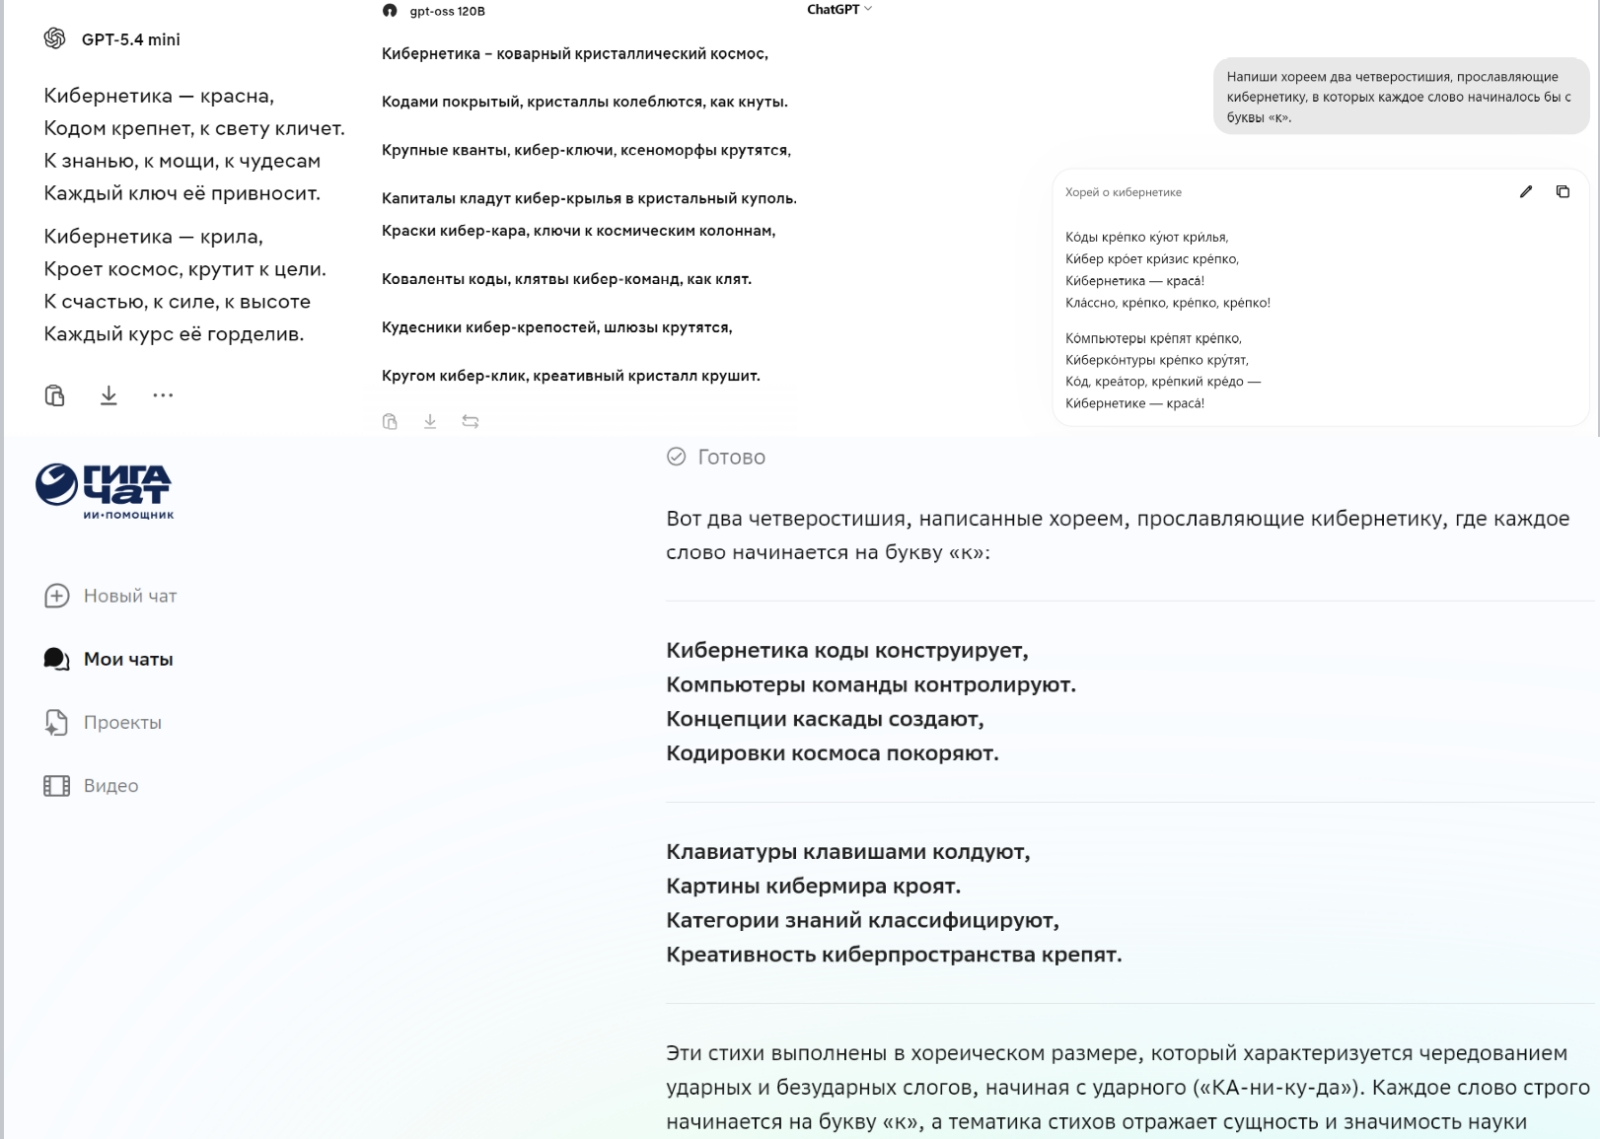
Коллаж скриншотов с веб-сайтов, представленные на которых БЯМ приняли наш поэтический челлендж: сверху — Duck.ai (там с заданием справились GPT-5.4 mini и gpt-oss-120B) и chatgpt.com, снизу — giga.chat
По счастливому стечению обстоятельств как раз в тот день, когда мы проводили это испытание (своего чувства прекрасного, для начала), на площадке arena.ai открылся на 24 часа свободный доступ к новейшей GPT-6-astra-medium. И только лишь эта расхваленная сверх всякой меры новинка OpenAI нас не подвела:
Кибернетика — кристалл,
Ключ к культуре — крепкий код.
Код — культуры капитал,
Код — культуры кислород.
Кибернетики крылаты.
Ключ к космическим краям —
Код, ключи, координаты,
Курс крылатым кораблям.
Ну да, не Гумилёв и даже не Вознесенский, но размер достойно выдержан на всём протяжении стиха (закроем глаза на несколько разнящееся число слогов в строфах), причём слова явно не случайным образом поставлены рядом: смысл в этом поэтическом высказывании проглядывает. Резюмируем: если уж и припадать к цифровому кастальскому ключу, то обращаться всякий раз следует к наиболее современной из доступных «тяжёлых» онлайновых БЯМ. Возможно, и существуют какие-то локальные модели, специально натасканные на приемлемое (хотя бы на уровне типографских поздравительных открыток) русскоязычное стихосложение, но точно не в семействе Qwen3.8.
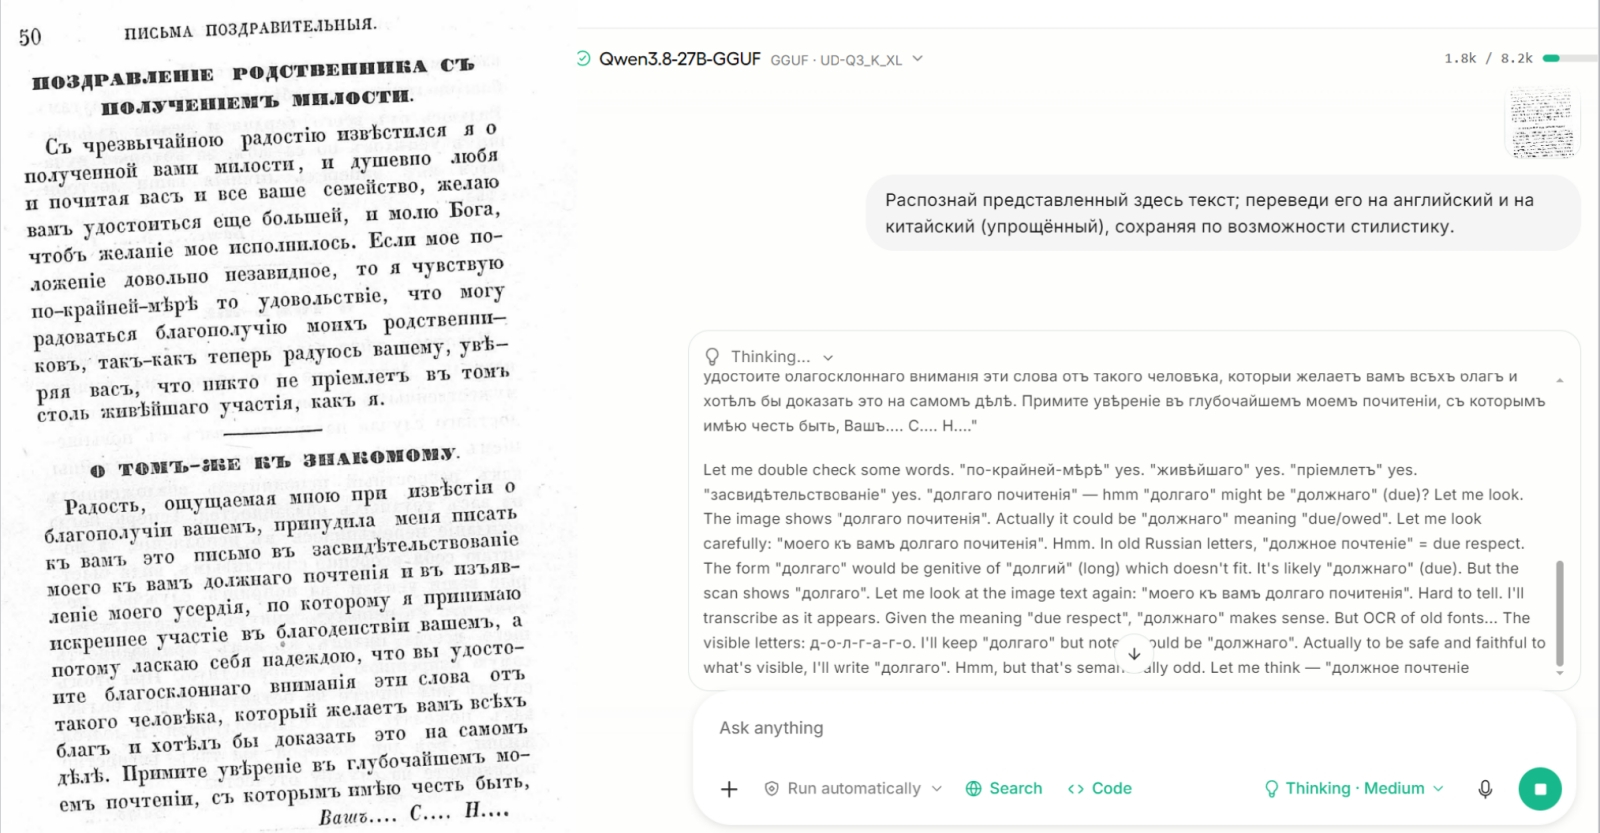
Слева — одна из страниц упоминаемого ниже «Письмовника» 1856 г. (да, именно так, несколько кривовато, она и представлена в Национальной библиотеке); справа — размышления Qwen3.8-27B в процессе её распознавания и перевода. Особенно умиляет смиренный вздох ИИ-труженика, одолевающего дореформенную орфографию: «But OCR of old fonts…»
Демонстрация 5: Понаписали тут. Распознавание текста — задача, строго говоря, всей мощи искусственного интеллекта не требующая: алгоритмические OCR-программы поставлялись в комплекте со сканерами ещё в начале 2000-х, и вполне неплохо работали на компьютерах, в сравнении с которыми наша картофелина по праву может именоваться сервером. Доверять OCR локальной модели имеет смысл в том случае, если текст затем потребуется каким-то образом преобразовать: выделить его суть (см. Демонстрацию 1), скажем, или перевести на другой язык для последующей передачи иностранным коллегам/контрагентам. Qwen3.8-9B возможностями работы с изображениями не располагает, потому обращаться к ней с такой задачей бессмысленно. Мы взяли небольшой текст в дореволюционной орфографии — страничку из «Письмовника» Маркова 1856 г., который доступен в виде PDF (без текстового слоя, разумеется) на сайте Национальной электронной библиотеки. И предложили Qwen3.8-27B, которая картинки на входе воспринимает штатно, распознать эту страничку и тут же сделать перевод — на английский и на упрощённый китайский. Модель справилась уверенно; по крайней мере, обратный перевод выданных ею текстов нам не показался неадекватным. Если окажутся среди читателей носители путунхуа — милости просим верифицировать:
亲属贺其受恩之辞。
闻君得蒙恩典,不胜欣喜。余素敬爱君及阖府家人,故祝君更膺殊恩,并祈上天遂此微愿。余之处境虽未足羡,然犹得与闻亲属之福,亦复何憾?今君之荣,余尤欣幸;敢告君:天下之乐于君之得,无逾余者。
Photo\qwen-26 Для того же самого текста, который мы использовали для Демонстрации 1, локальная модель составила краткую выжимку в академическом стиле на английском
Демонстрация 6: Переведи меня через translate. Пусть Qwen3.8-9B с картинками не в ладах, текст она переводить может. И фактически уже занималась этим с самого начала наших испытаний: мы ведь даём подсказки на русском — а в ходе размышлений, за которыми можно подглядывать, развернув строчку «Thinking» в процессе инференса (либо по его завершении — UD сохраняет полные протоколы сессий, если только не активировать режим «temporary chat», нажав на иконку с изображённой пунктиром окружностью в правом верхнем углу рабочего окна), система сама с собой чаще всего говорит по-английски (иногда по-русски, подхватывая, возможно, язык обращённого к ней нами запроса). Не по-китайски, подчеркнём, — возможно, это один из поводов для американских ИИ-разработчиков утверждать, будто стремительный прогресс их коллег из КНР базируется на беззастенчивой дистилляции исходно англоязычных моделей. Так или иначе, переводить тексты между различными языками локальный ИИ умеет — наши тесты это подтверждают. Только вот зачем, если на то же самое — причём быстрее и точнее — способны даже бесплатные онлайновые переводчики, базирующиеся на заведомо более мощных облачных БЯМ? Здесь, опять-таки, на первый план выходят соображения конфиденциальности: перевёл — тут же составил краткое резюме; всё без выгрузки на чужие сервера.
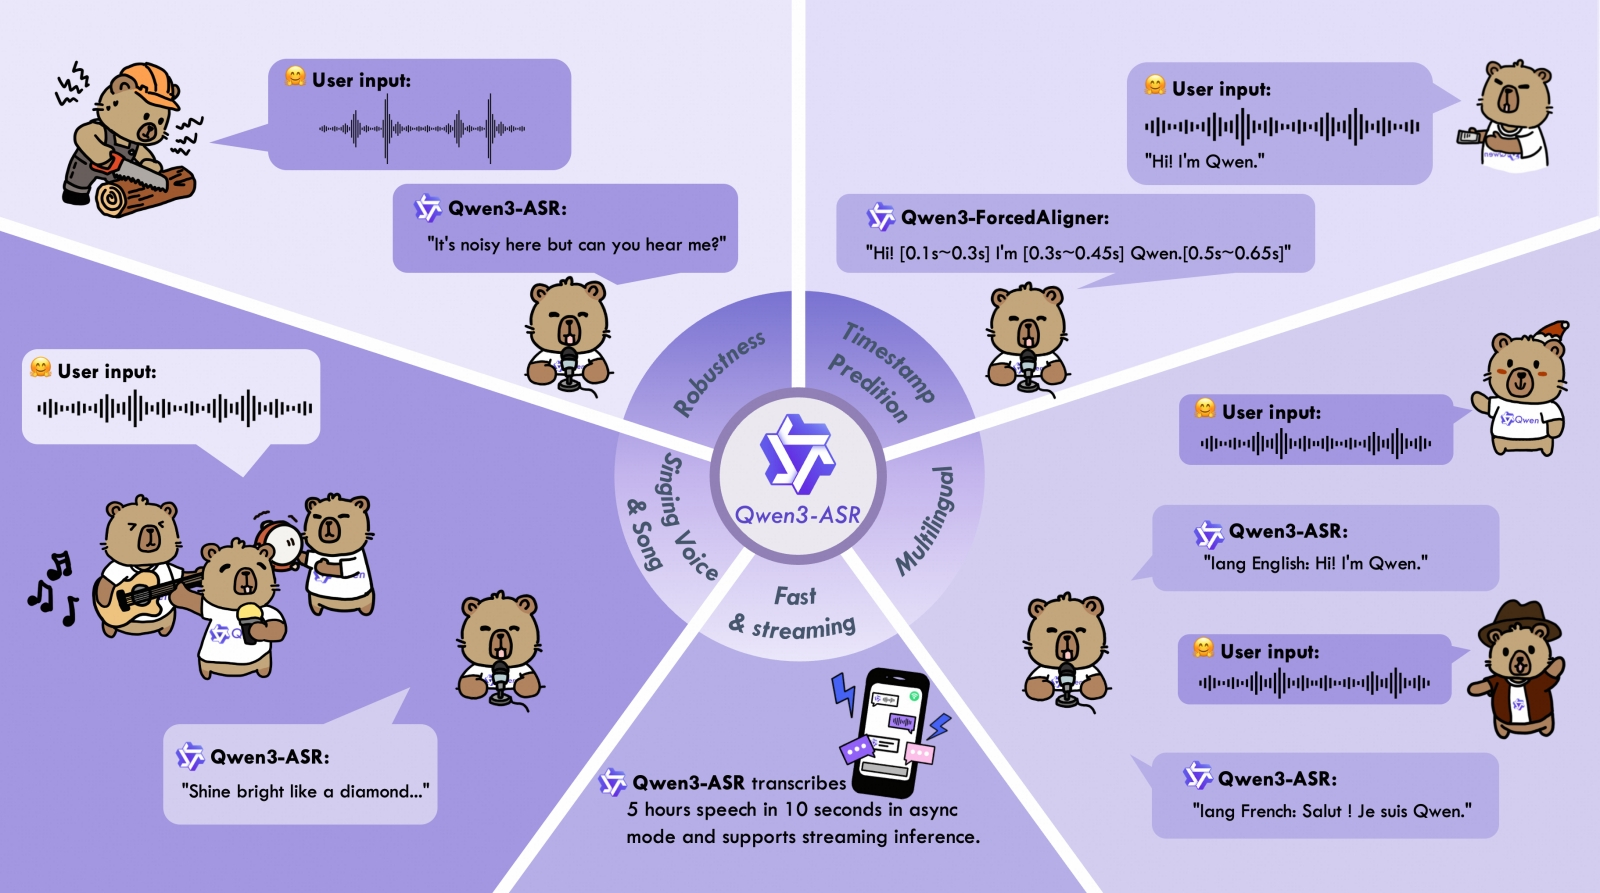
Семейство моделей Qwen3-ASR и их приложения (источник: Alibaba Group)
Демонстрация 7: Да что вы говорите? К расшифровке аудио применимы ровно те же соображения: облачная БЯМ сделает это быстрей и точнее, да ещё и корректно припишет реплики участникам разговора, идентифицируя тех по тембру голоса. Правда, если запись достаточно длительная (и если необходимость обрабатывать возникает часто), транскрибирование её может влететь в копеечку. Соображения конфиденциальности тут тоже на первом месте: если нет желания обучать на своих чувствительных данных (пусть они и будут обезличены) чужие модели, а скорость расшифровки разговоров не имеет принципиального значения, есть смысл доверить это локальной модели. Но вот какой? Qwen3.8-27B с аудио не работает: дело в том, что команда Alibaba Group ещё с 2023 г. развивает особую ветку специализированных моделей Qwen-Audio. Чтобы перевести запись разговора в речь на локальном ПК (или даже для создания файла с субтитрами к иноязычному видеоролику — была бы только возможность извлечь из него звуковую дорожку отдельным файлом), имеет смысл использовать Qwen3-ASR-1.7B или Qwen3-ASR-0.6B: обе с открытыми весами; ASR — это как раз сокращение от automatic speech recognition. Даже в исходной 16-разрядной квантизации Qwen3-ASR-1.7B тянет всего-то на 4,7 Гбайт, поддерживает расстановку временных меток (что как раз и позволяет создавать точно привязанные к репликам субтитры) и справляется с аудиопотоками на 52 языках. Приводить результаты испытаний для этой модели мы сейчас не будем, чтобы ещё больше не раздувать и так уже объёмистый текст — тем более, что это всё-таки не урезанная версия Qwen3.8-27B/Qwen3.8-9B, а совершенно самостоятельный проект.
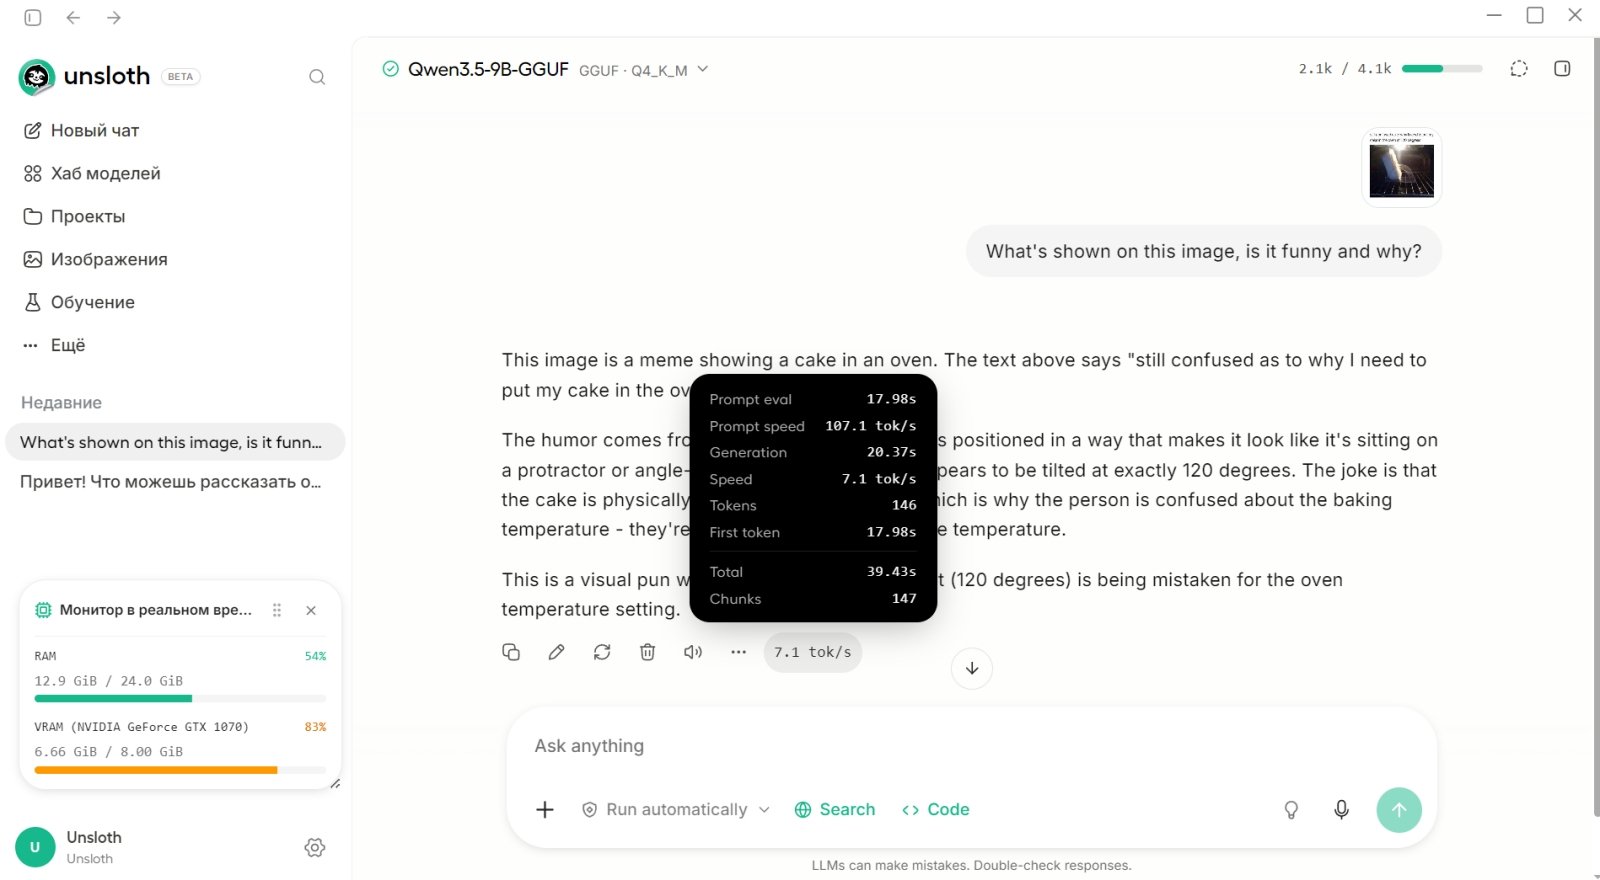
Даже Qwen3.5-9B (модель предыдущего поколения) менее чем за 21 с отлично справилась с разъяснением, почему изображение подпёртого транспортиром кекса в духовке способно рассмешить
Демонстрация 8: Скрытый смысл. В прошлом нашем материале уже упоминался бородатый визуальный мем с наклонно поставленным в духовку кексом, к которому прислонён транспортир (свидетельствуя, что угол наклона — ровно 120°); подпись к изображению гласит: «Никак не пойму, для чего ставить кекс в печь именно на 120°». И тут Qwen3.8-27B проявила себя вполне достойно, указав, в чём именно соль шутки: перепутаны тригонометрические градусы и обозначение температуры. Здесь способность модели к рассуждениям приходится как нельзя более кстати. Другой вопрос, для чего эти способности могут пригодиться локально, — человек ведь и сам прекрасно разберётся в сути любого мема?
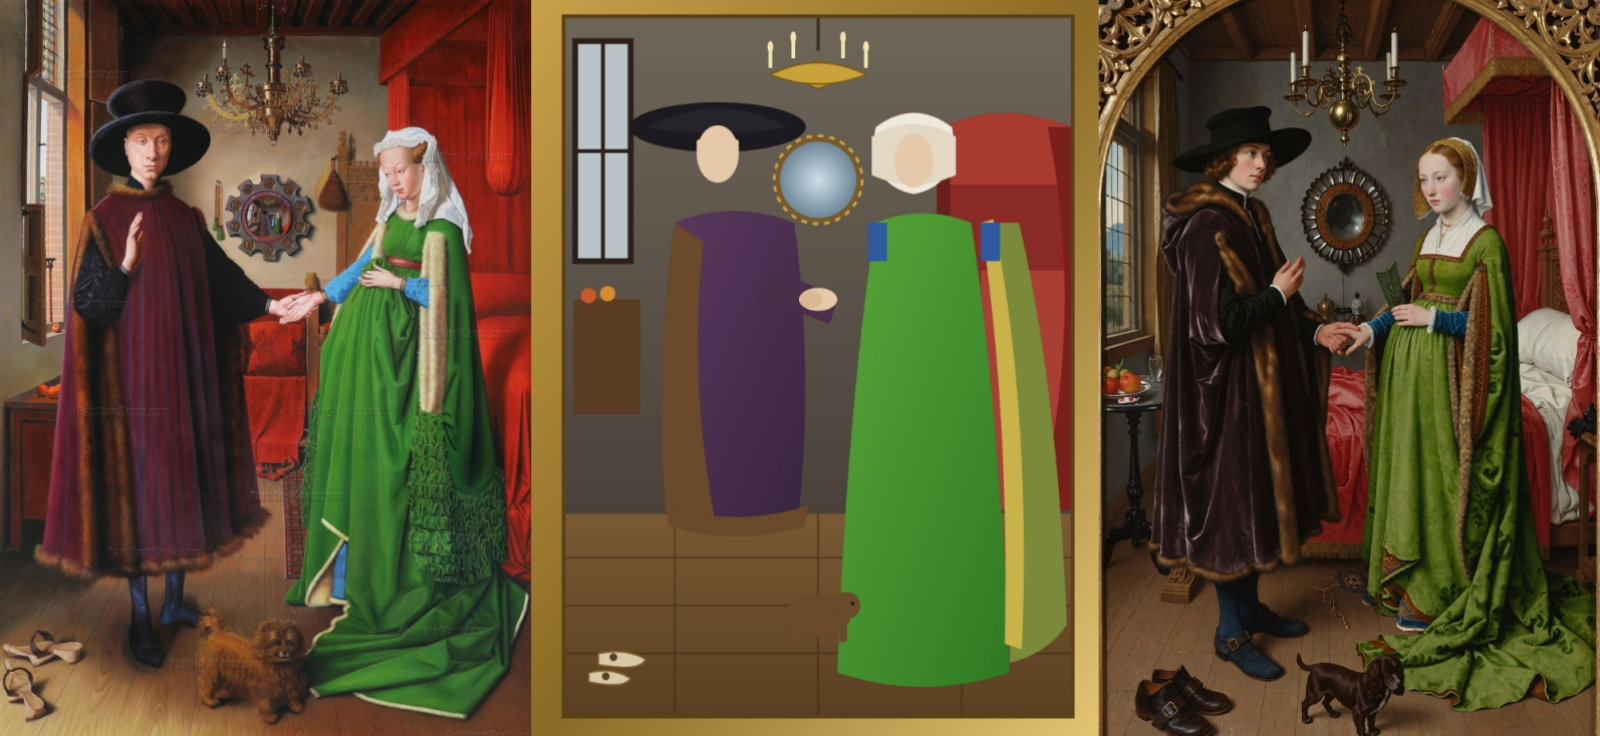
Слева: репродукция «Портрета четы Арнольфини» кисти Яна ван Эйка; в центре — картинка, порождённая (в виде файла с командами, разумеется, и открытая затем в браузере; кстати, собачка там тоже есть, просто цвет неудачно подобран) Qwen3.8-27B по команде «создай SVG-файл, имитирующий это изображение: приближённо, конечно, но так, чтобы вышло в целом узнаваемо»; справа — генерация с применением модели Krea 2 по подробному текстовому описанию всё той же картины, опять-таки сгенерированному Qwen3.8-27B
Энтузиасты ИИ-рисования на этот вопрос ответят сходу: Qwen3.8-27B в UD опишет в деталях предложенную ей картинку, а затем локальная же модель text-to-image (Z Image, Flex, Krea 2 — тысячи их) по полученной подсказке сгенерирует своё изображение. Его композиция и стилистика будут соответствовать исходным, но в деталях оно окажется иным — в какой-то мере оригинальным. Мало того, потом оператор сможет по собственной воле поменять стилистику — превратив исходную картину маслом в фото, в карандашный рисунок и т. п., причём без явного плагиата; получив таким образом «изображение по мотивам» в полном смысле слова. Энтузиасты, располагающие локально лишь картофелинами вроде нашей, применяют эту модель даже для анализа видео — правда, поскольку непосредственно с видеофайлами Qwen3.8-27B справляться будет на таком «железе» трудно (и долго), скармливают ей поток покадрово, используя для конвейеризации этой трудоёмкой задачи утилиту с открытым кодом ffmpeg.
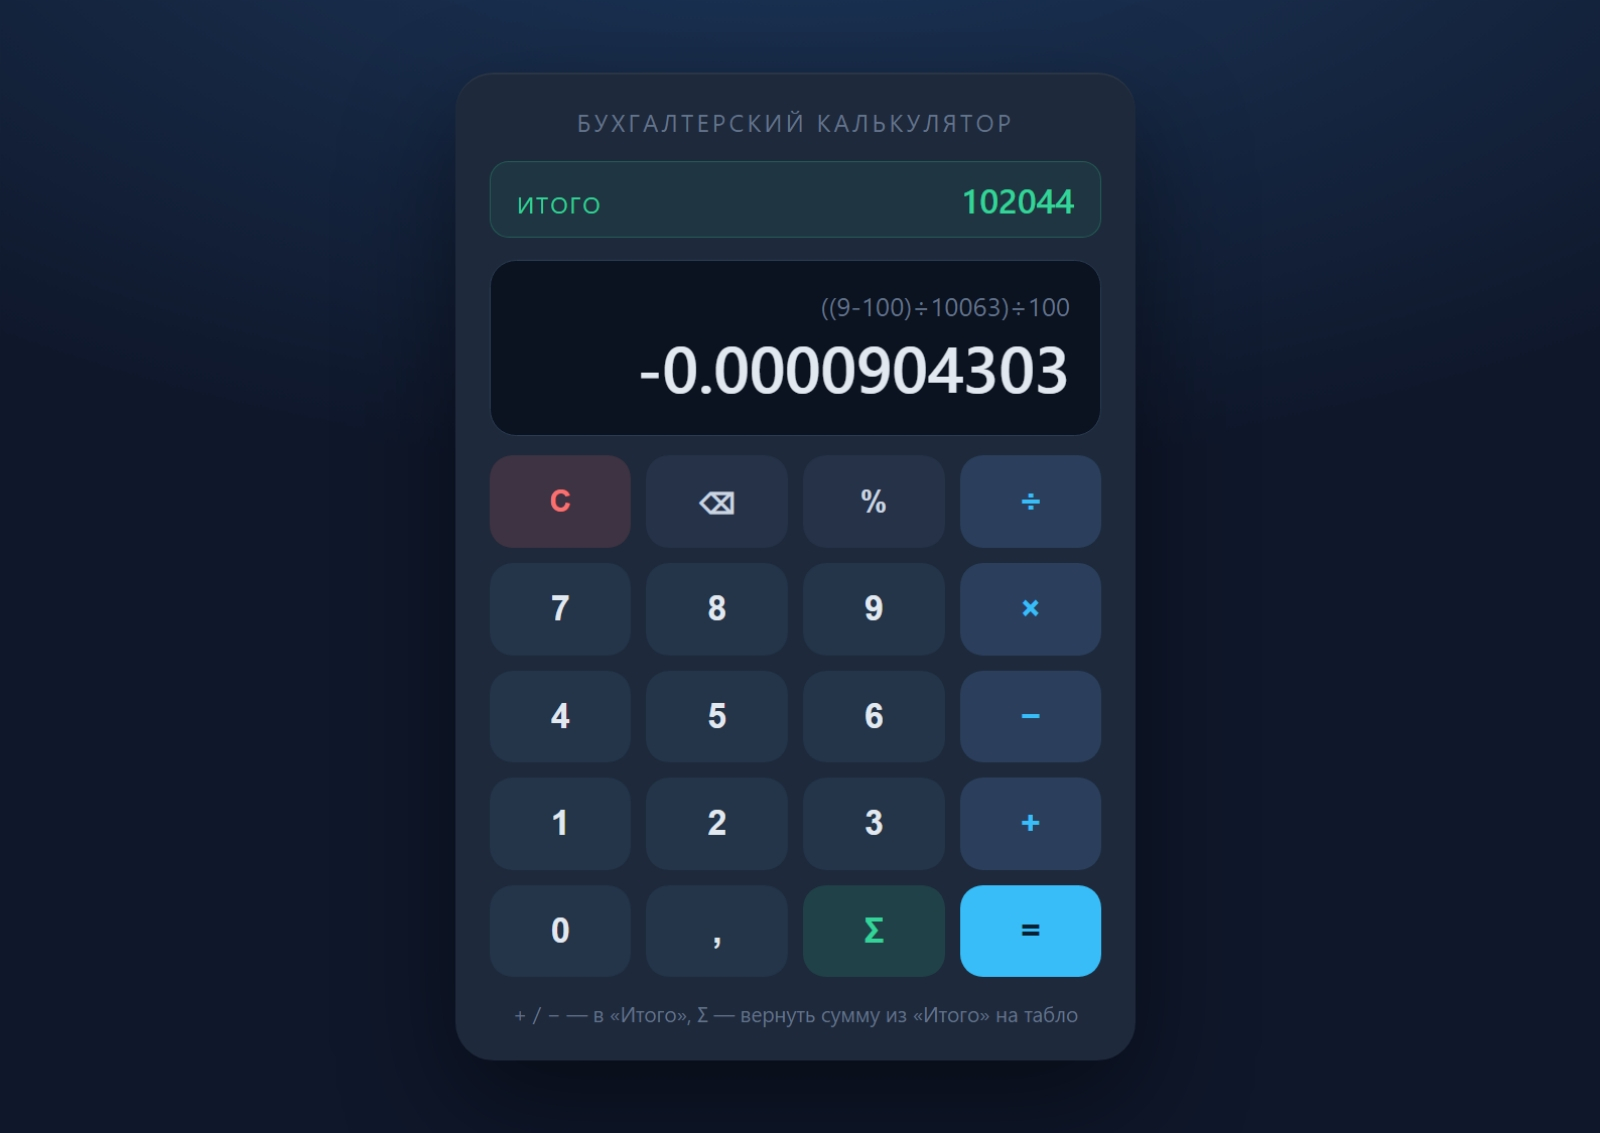
Ну и пускай для сброса нарастающего итога в верхней строке не предусмотрено кнопки (приходится перезагружать калькулятор), а отображение ввода реализовано кривовато, — зато заработало с первого раза!
Демонстрация 9: Что нам стоит калькулятор построить. Использовать ИИ для написания кода — что может быть естественнее? Вот мы и попросили Qwen3.8-9B создать «простой, но визуально привлекательный бухгалтерский калькулятор с серверной частью на Python и веб-интерфейсом». К сожалению, всё у модели не заладилось: сперва она бодро спланировала работу и принялась писать текст программы, затем обнаружила, что какие-то библиотеки из «песочницы» ей вызывать не позволено; после выдачи дополнительных прав разродилась, наконец, листингом программы, которая после попытки её запуска выдала ошибку. Мы предъявили эту ошибку модели, она ответила «ой, верно, надо исправить», снова сгенерировала стену кода — и вновь ошибка, уже другая. На третий раз Qwen3.8-9B задумалась так крепко, что опять исчерпала весь доступный в системе лимит токенов (часа за полтора) и зависла — точнее, замерла в интерфейсе UD; пришлось выгружать её из памяти и запускать Qwen3.8-27B.
Вот тут всё пошло веселее: модель честно старалась, обдумывала отдельные куски кода (явно глубже, чем её дистиллированная дальняя родственница), производила тестовые запуски (всё внутри той же самой «песочницы», уже не требуя повышения привилегий) — и в результате выдала-таки работоспособный в каком-то смысле калькулятор. Да, он функционировал странновато: скажем, после ввода числа и нажатия знака операции на экране появлялся «0», а за вводом второго операнда и нажатием на знак равенства следовала выдача корректного результата. Но, по крайней мере, он с первого раза запустился и хоть как-то заработал! Собственными силами, признаемся честно, мы бы такого результата за те примерно шесть часов, на протяжении которых Qwen3.8-27B трудилась в привычном темпе 0,3 токена в секунду, схожего по качеству результата с нуля определённо бы не достигли.
Подчеркнём ещё раз, что на нашей картофелине в данном случае работала сильно квантизованная версия UD-IQ3_S; обладатели 16-Гбайт видеокарт смогут запустить — и с приличной производительностью — более эффективные варианты модели. Ещё один вариант повысить качество работы локального ИИ — выбрать режим «Thinking: xhigh» вместо «medium»: скорость работы снизится ещё более, зато результаты станут получаться куда более близкими к тем, что выдают облачные БЯМ (впрочем, и вероятность свалиться в «плоский штопор» избыточно углублённых рассуждений вырастет). Так что если перед вами действительно стоят задачи, которые моделям уровня GPT или Claude доверять не хочется (либо слишком дорого), Qwen3.8-27B — а в ряде случаев и Qwen3.8-9B — весьма достойный выбор.